Jak ChatGPT naprawdę pisze odpowiedź? Token po tokenie
Cięcie na tokeny, liczby, maszyna i losowanie następnego kawałka. Z prawdziwymi pomiarami, które możesz sprawdzić sam.
Premiera wkrótce · pełna wersja tekstowa jest poniżej
To nie jest ChatGPT. Cięcie zdania na tokeny pokazuję słownikiem o200k_base, którego używają modele GPT-4o. Rozkłady prawdopodobieństw i losowania pochodzą z małego, otwartego modelu Qwen3-0.6B-Base (0,6 mld parametrów), bo takiego mogę uruchomić u siebie i zajrzeć do środka. Qwen3 ma własny słownik (151 669 pozycji), inny niż o200k_base, więc to samo zdanie tnie na inną liczbę tokenów i z innymi numerami.
Co dzieje się, gdy naciskasz Enter
Wpisujesz pytanie. Naciskasz Enter. I po chwili odpowiedź wyskakuje na ekranie, kawałek po kawałku.
 Animacja · przesuń suwak
Wygląda, jakby ktoś po drugiej stronie pisał. Nikt tam nie pisze.
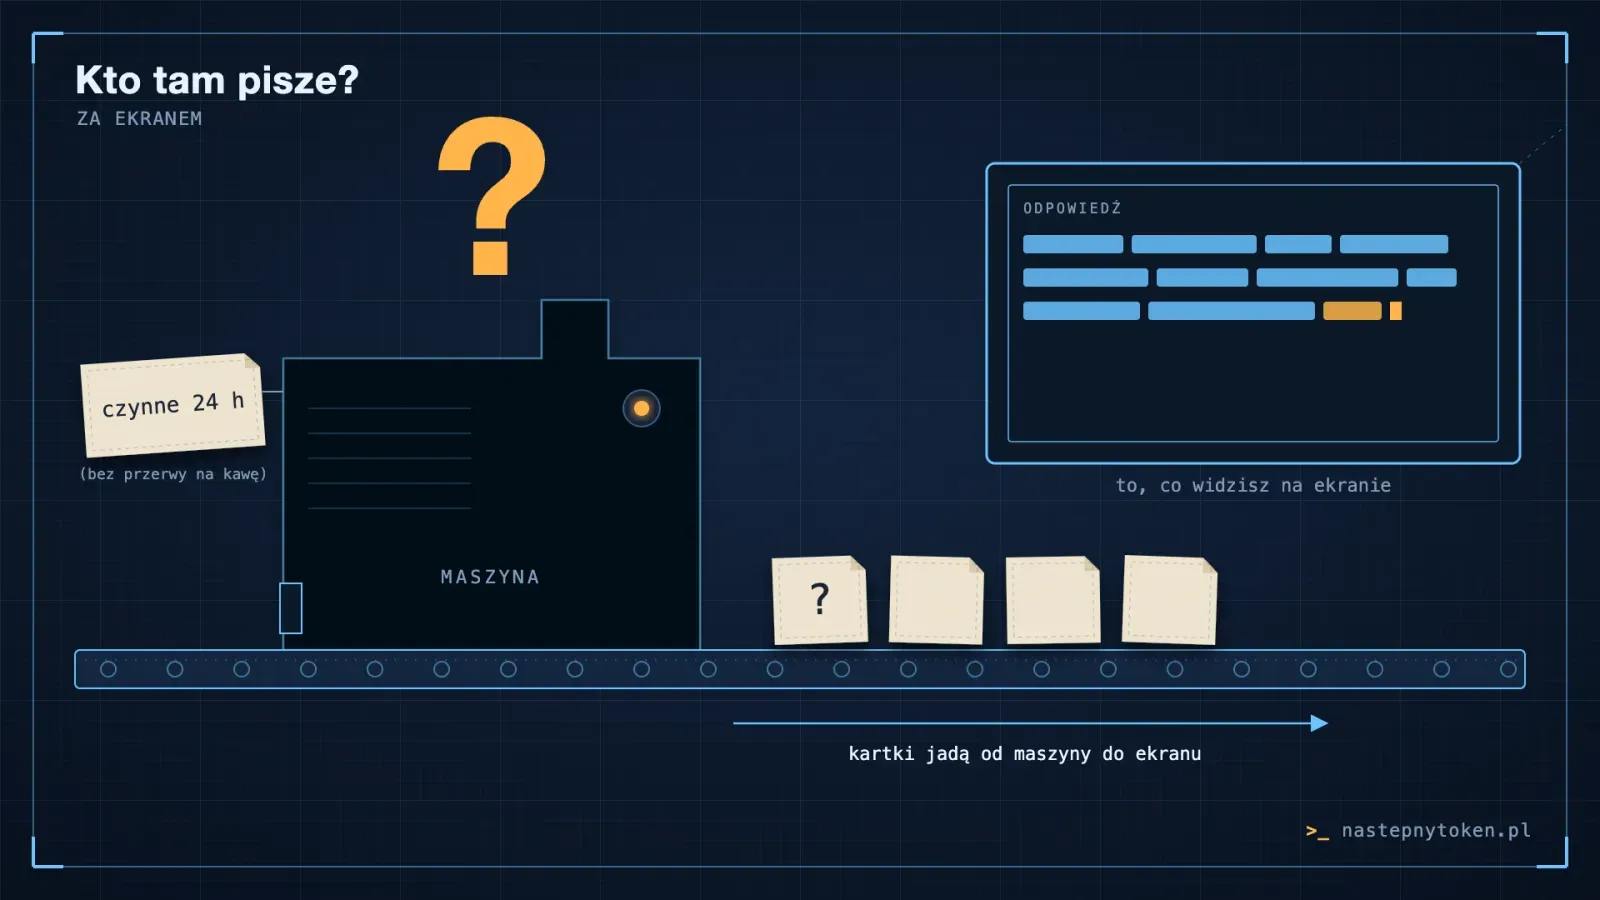
Odpowiedź pojawia się po kawałku, ale nikt jej nie pisze. Kadr z odcinka.
Po drugiej stronie stoi maszyna, która robi w kółko jedną, jedyną rzecz: zgaduje, co powinno być następne. Cała odpowiedź, którą czytasz, to tysiące takich zgadnięć, jedno po drugim. Dzisiaj rozbierzemy tę maszynę na części i zobaczysz każdą z nich.
Plan: cztery przystanki
Mamy cztery przystanki. Pierwszy: twoje zdanie zostaje pocięte na kawałki.
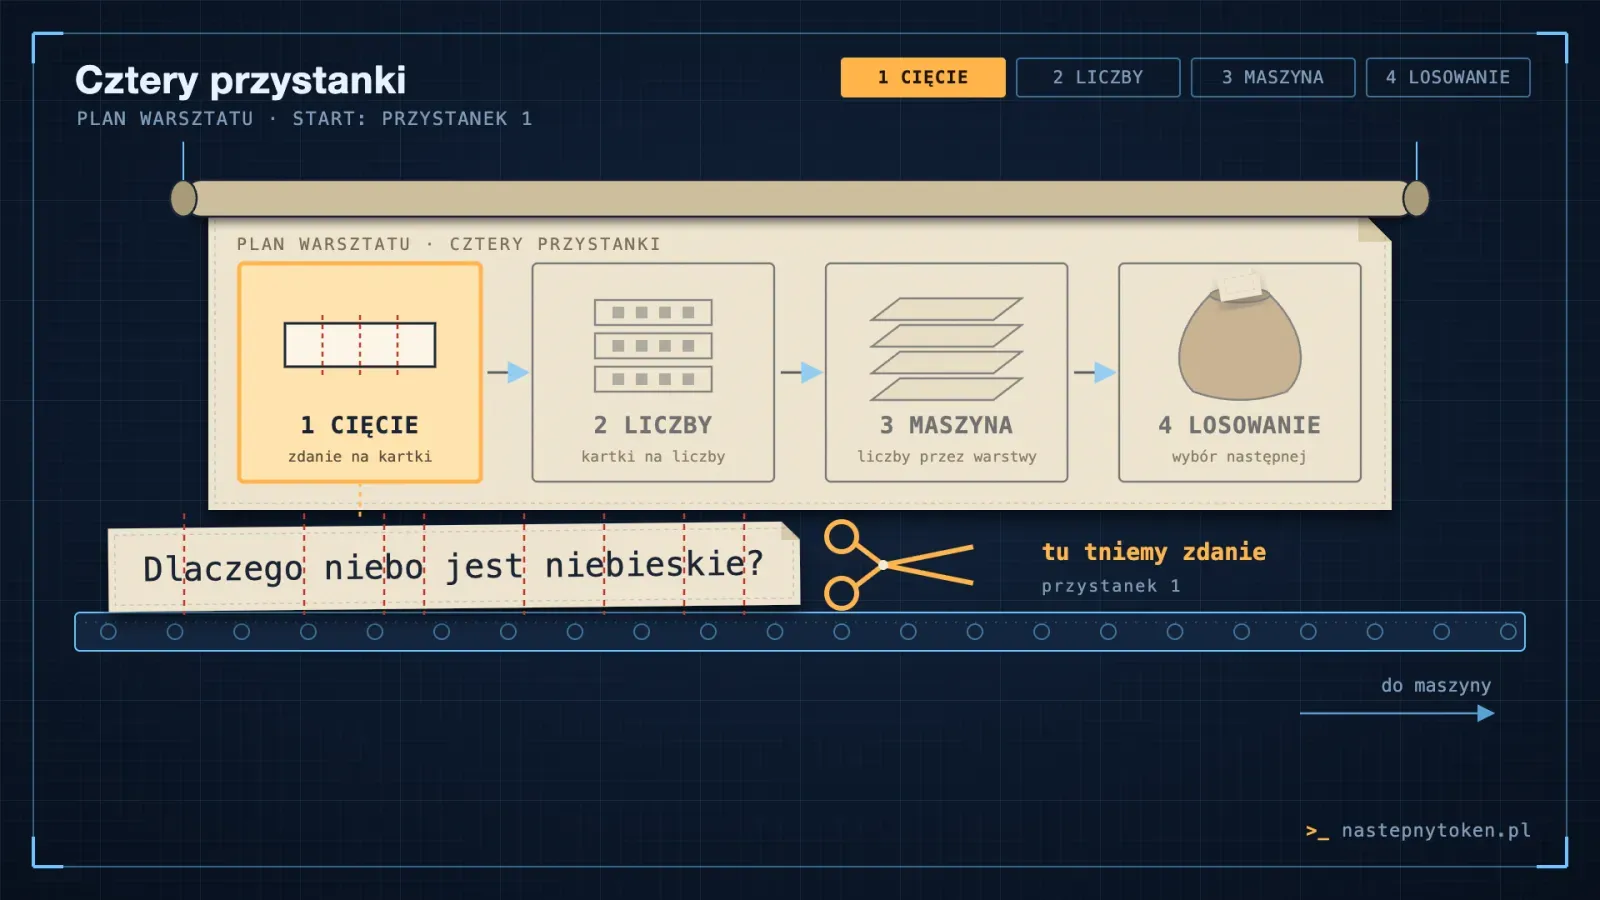
Cztery przystanki odcinka. Kadr z odcinka.
Drugi: kawałki zamieniają się w liczby. Trzeci: liczby przechodzą przez maszynę. Czwarty: maszyna wybiera następny kawałek, i cała zabawa zaczyna się od nowa. Każdą liczbę, którą zobaczysz, można sprawdzić. A na końcu pokażę, co w tym mechanizmie uprościłem. Rozkładamy to na stole. Zaczynamy.
Przystanek 1: cięcie na tokeny
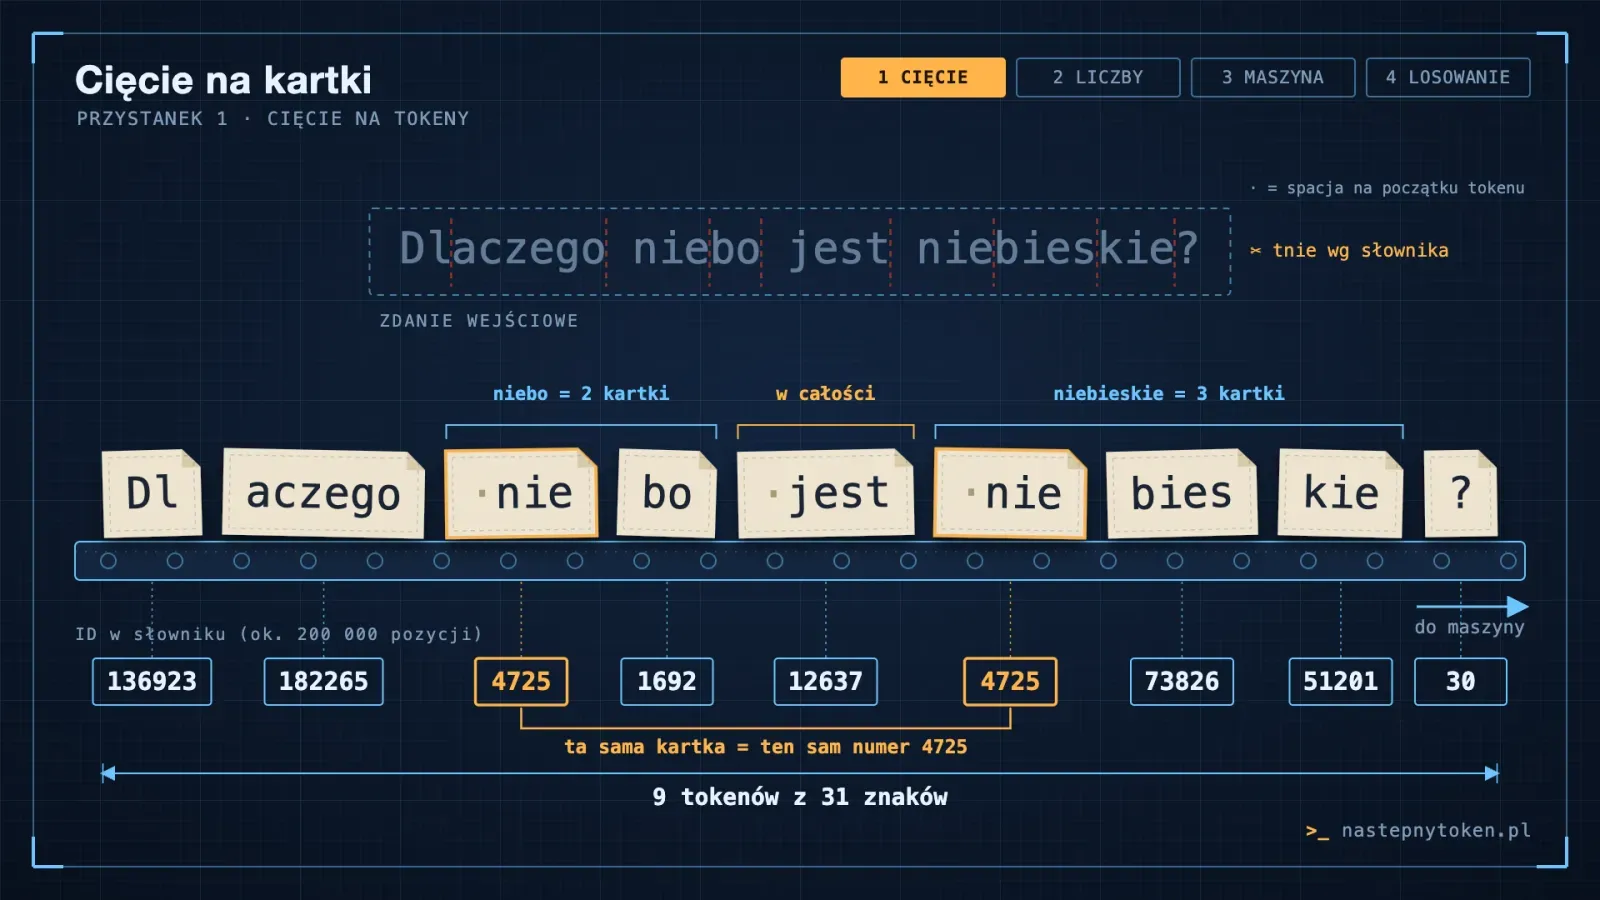
Pierwsza rzecz, która cię zaskoczy: maszyna nie czyta liter ani całych słów. Czyta tokeny. Token to kawałek tekstu. Czasem całe krótkie słowo, czasem pół słowa, czasem spacja razem z pierwszą literą, czasem pojedynczy znak. Każda kartka na tej taśmie to jeden token. Zobacz, co się dzieje z tym zdaniem. Tnę je. Popularne słowa często zostają w całości, jak jest. Rzadsze i dłuższe rozpadają się na kilka kartek.
 Animacja · przesuń suwak
Niebo to dwie kartki: nie i bo. A niebieskie to nie, bies i kie. Zauważ, że kartka nie pojawia się dwa razy i za każdym razem ma ten sam numer.
Uwaga: spacja przed słowem należy do kartki. Słowo nie ze spacją i bez spacji to dwie różne kartki, z różnymi numerami. Wpisuj całe zdanie.
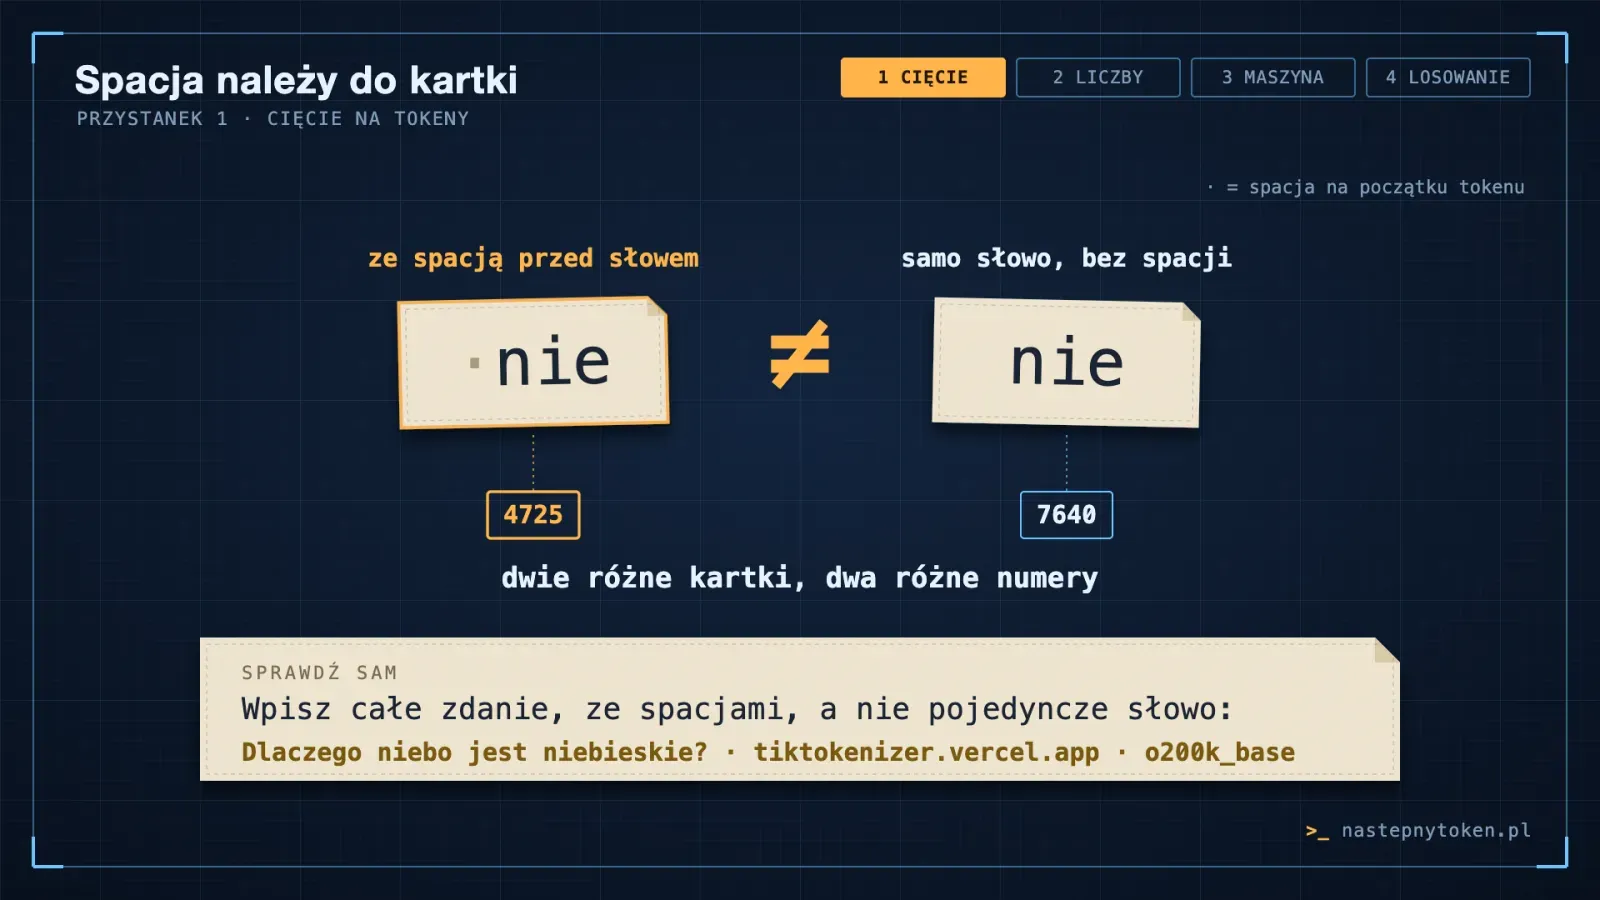
Spacja jest częścią kartki: ze spacją to numer 4725, bez spacji 7640. Wpisuj całe zdanie. Kadr z odcinka.
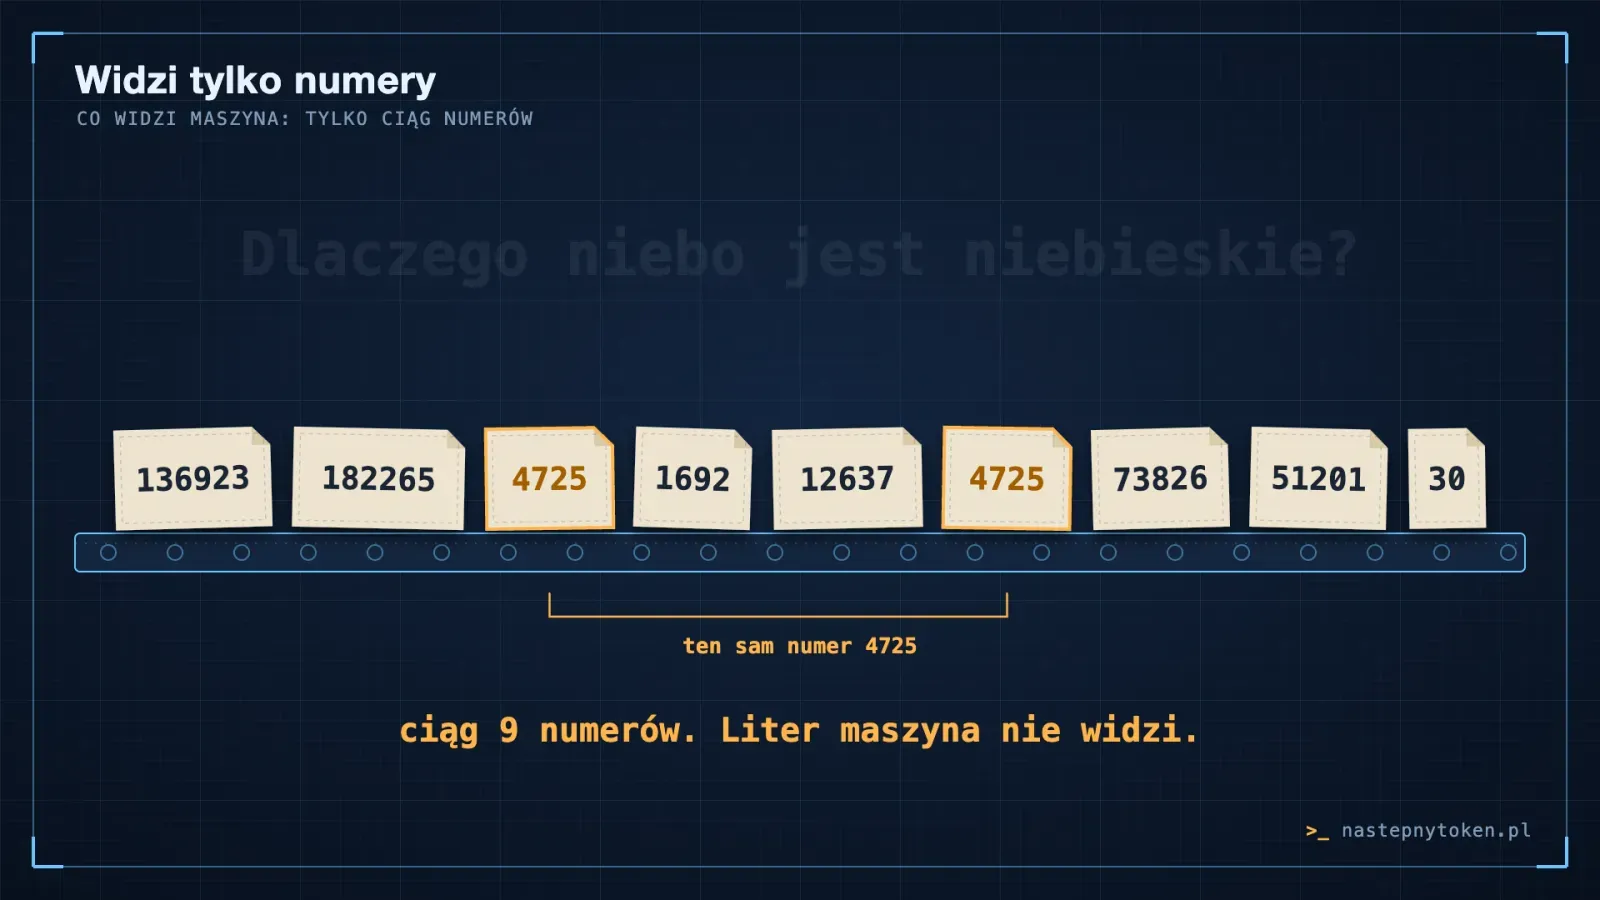
Skąd maszyna wie, jak ciąć? Ktoś wcześniej przejrzał ogromną ilość tekstu i ułożył słownik najczęstszych kawałków. W tym, który tu pokazuję, jest ich około dwustu tysięcy. Każdy kawałek ma w nim swój numer. I teraz uwaga: maszyna nie widzi tekstu. Maszyna widzi tylko ciąg numerów.
 Animacja · przesuń suwak
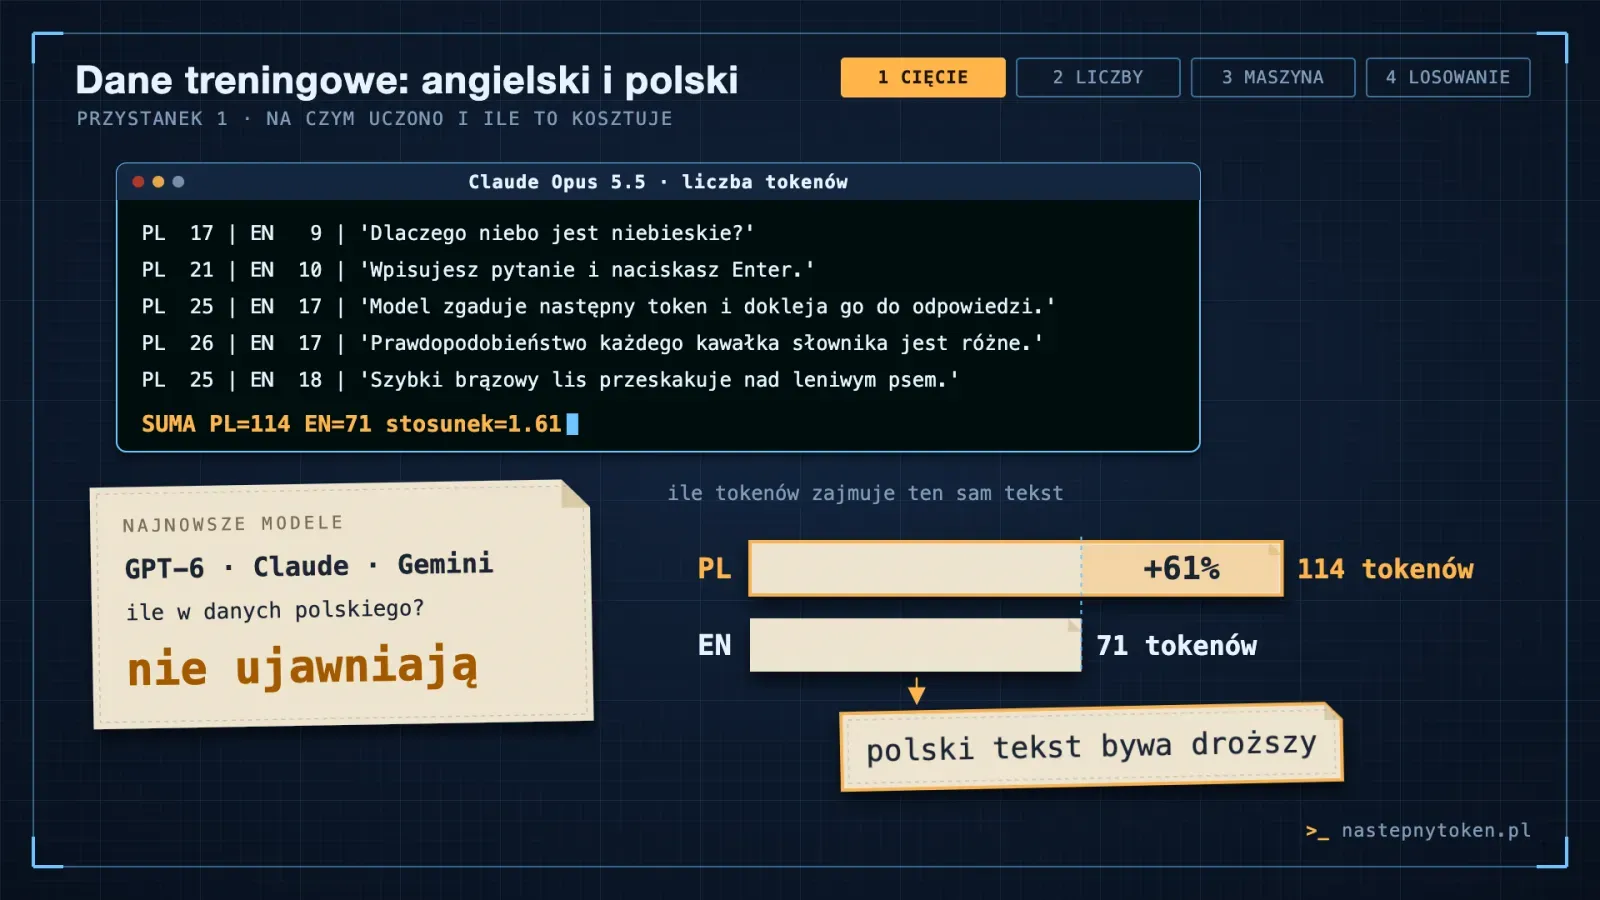
A teraz coś, co dotyczy nas osobiście. To samo pytanie po angielsku to sześć kartek. Po polsku: dziewięć. Zmierzyłem to na pięciu parach zdań: polskie wersje potrzebowały średnio około półtora raza więcej tokenów.
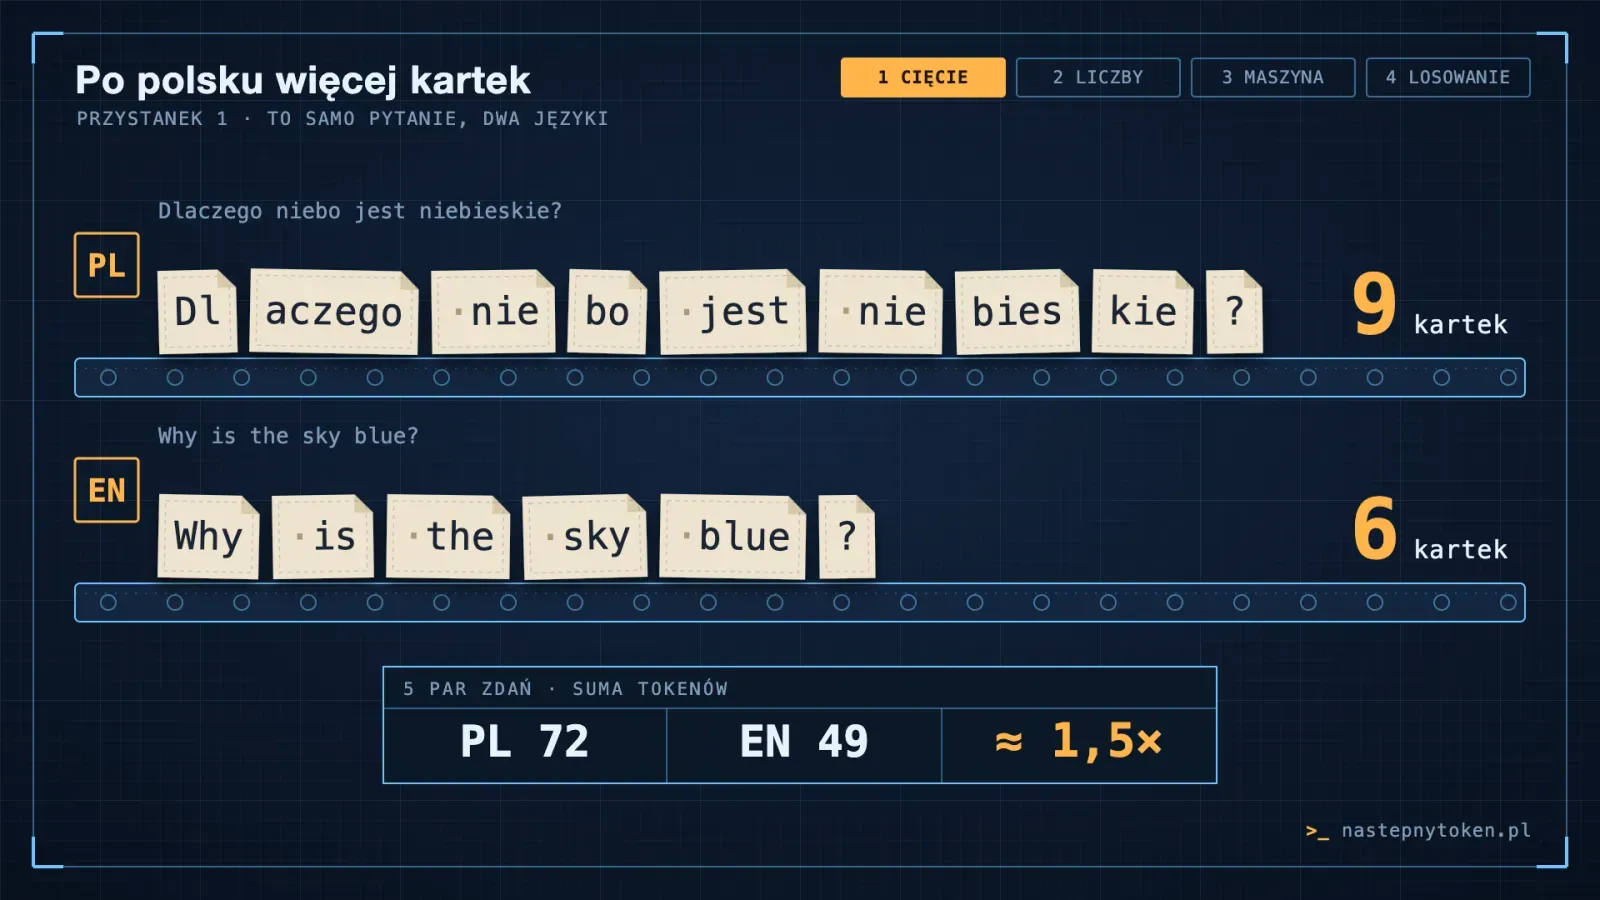
Mój pomiar na pięciu parach zdań: polskie wersje miały średnio ok. 1,5 raza więcej tokenów. To mała próbka, nie reguła. Kadr z odcinka.
Badacze pokazują, że ten sam tekst w różnych językach potrafi dać bardzo różną liczbę tokenów, a to przekłada się na koszt i na to, ile tekstu zmieści się w kontekście. Pierwsze duże modele uczono głównie na angielskim: w GPT-trzy to było dziewięćdziesiąt trzy procent słów, a polskiego zaledwie szesnaście setnych procenta. O najnowszych modelach tego nie wiemy, bo firmy tego nie ujawniają. Zmierzyłem za to Claude’a Opus pięć i pół: na tych samych pięciu parach zdań po polsku potrzebuje o około sześćdziesiąt procent więcej tokenów. Praktyczny wniosek: polski tekst bywa po prostu droższy.
 Animacja · przesuń suwak
Ten pomiar da się powtórzyć: przepis jest w eksperymencie o tokenach w Claude.
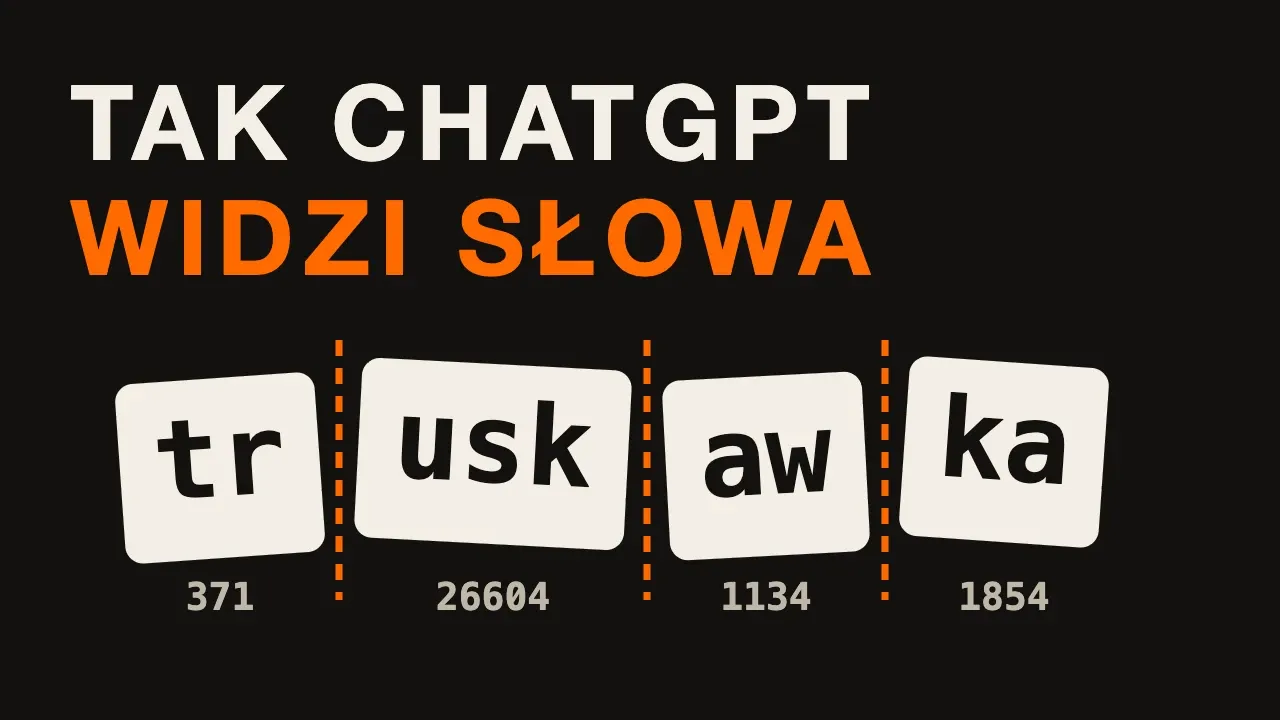
Przy okazji: słowo truskawka maszyna widzi jako cztery kartki: tr, usk, aw, ka. Pojedyncze litery nie są dla niej osobnymi elementami.
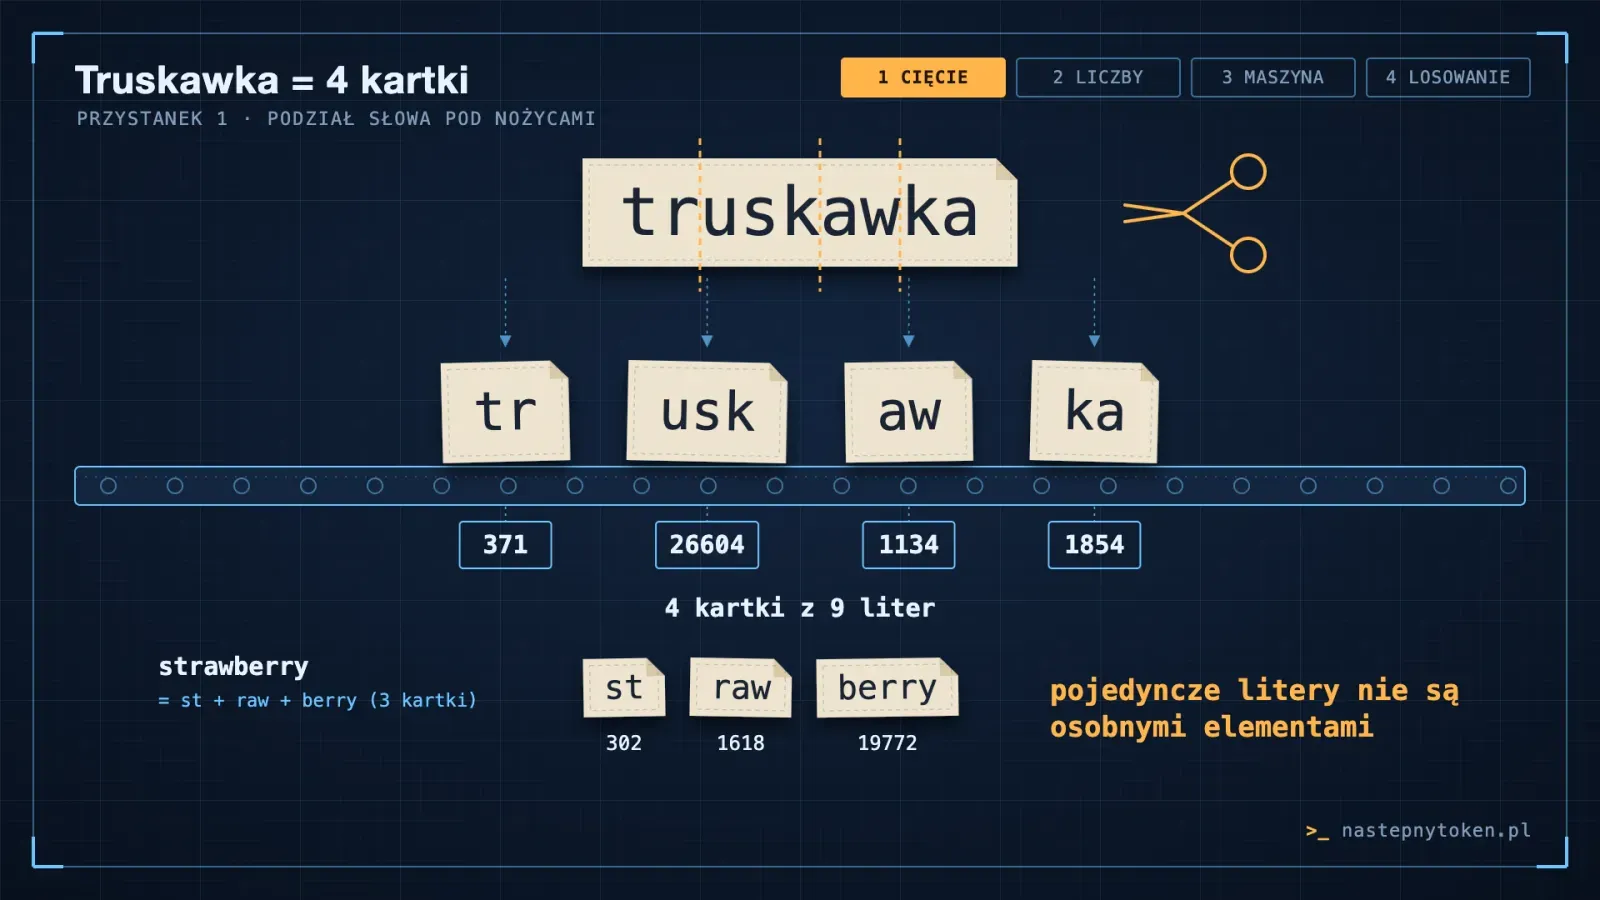
Cztery kartki zamiast dziewięciu liter. Kadr z odcinka.
Przystanek 2: liczby i mapa znaczeń
Numer to jeszcze nie znaczenie. Numer siedemdziesiąt cztery tysiące czterysta czterdzieści trzy, to jest numer słowa kot w słowniku, nie mówi maszynie nic o tym, czym jest kot, a czym czajnik. Dlatego każdy numer jest zamieniany na długą listę liczb. Nazywamy ją wektorem. Wyobraź to sobie jak współrzędne na ogromnej mapie. Nie dwie współrzędne, jak na mapie miasta, tylko setki, a w dużych modelach tysiące.
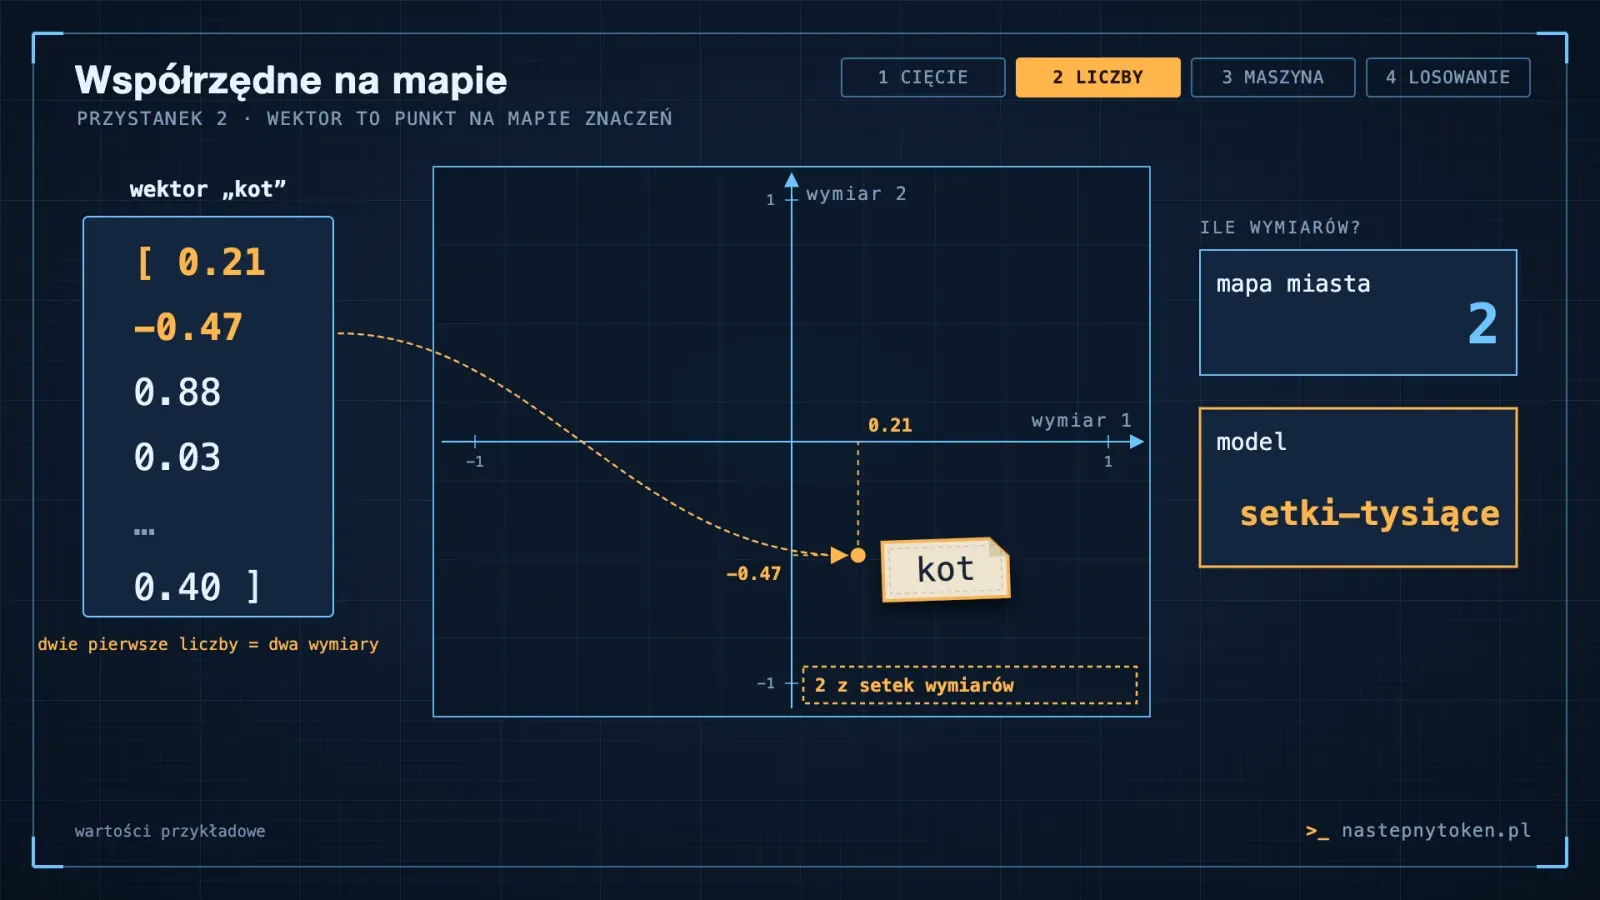
Wektor to lista liczb. Schemat poglądowy, pozycji słów nie mierzyłem. Kadr z odcinka.
Na tej mapie słowa o podobnym znaczeniu lądują blisko siebie. Kot niedaleko psa. Czajnik niedaleko garnka. I jeszcze jedno. Maszyna musi wiedzieć, w jakiej kolejności leżą kartki. Pies gryzie człowieka to nie to samo, co człowiek gryzie psa. Dlatego do każdej kartki dochodzi też informacja o jej miejscu w ciągu.
Przystanek 3: maszyna
Teraz kartki wjeżdżają do maszyny. W środku jest stos warstw, jedna za drugą.
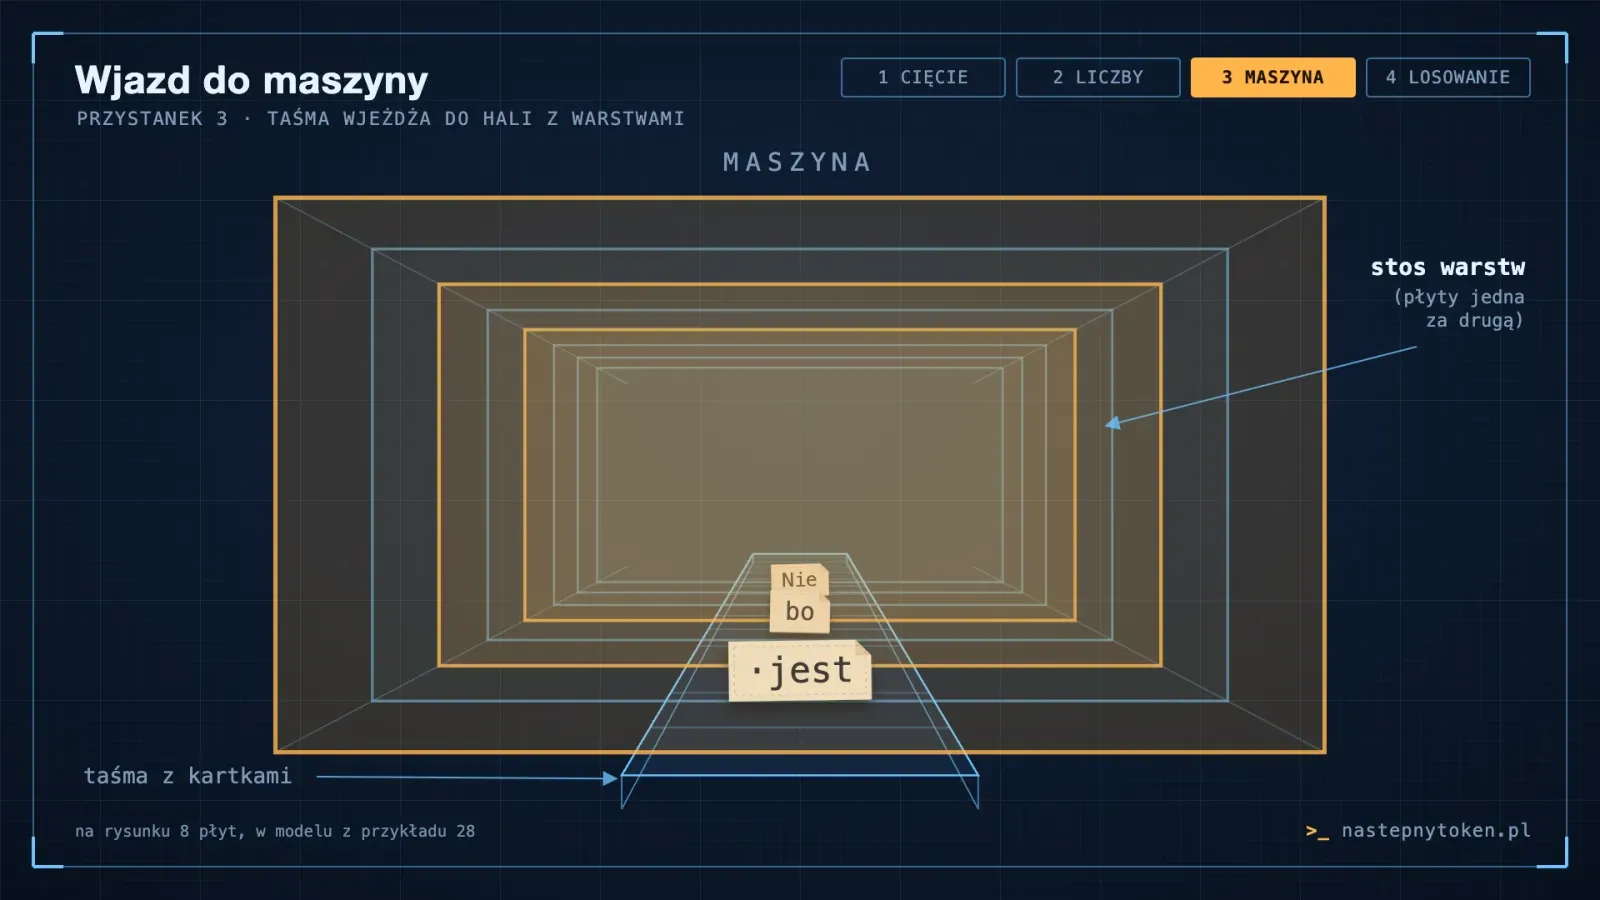 Animacja · przesuń suwak
W każdej warstwie kartka może zajrzeć do kartek, które leżą przed nią, i wziąć od nich trochę informacji. Po co? Weź słowo zamek. W zdaniu o kurtce to suwak, w zdaniu o królu budowla. Kartka sama tego nie wie, więc sprawdza, co leży wcześniej. Najwięcej bierze od tych kartek, które w tym miejscu najbardziej się liczą. Ten mechanizm nazywa się attention, czyli uwaga. Jak działa w szczegółach, to temat na kiedy indziej. Powiem tylko tyle: po każdej warstwie współrzędne kartek się zmieniają, bo wzbogaca je kontekst pozostałych. W modelu, na którym liczyłem przykłady, jest ich dwadzieścia osiem.
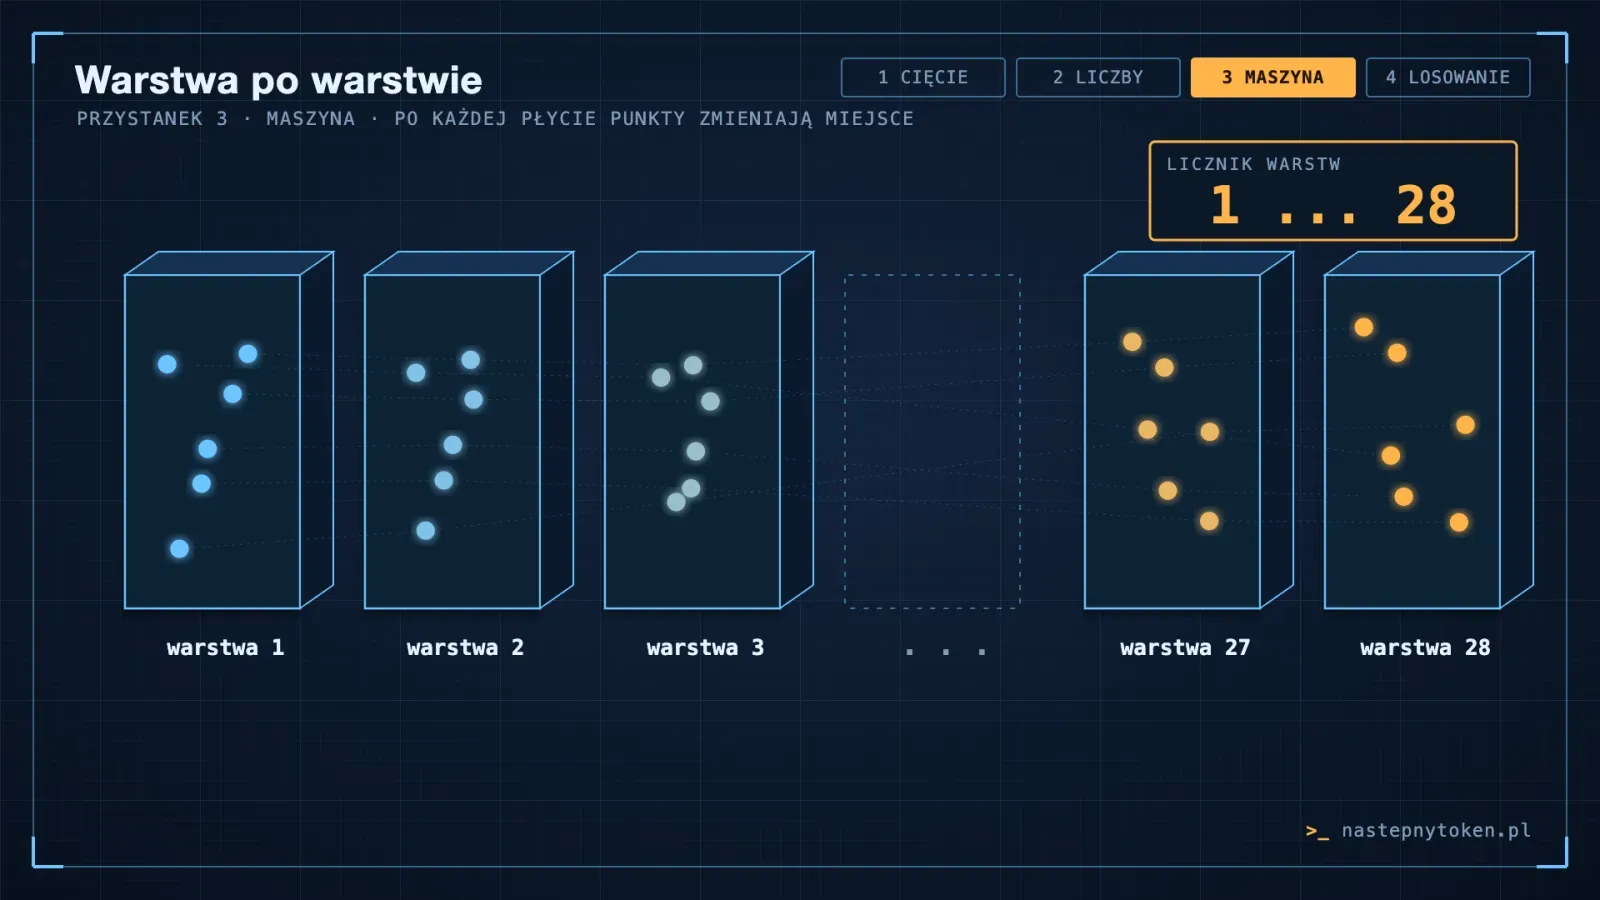
Model z przykładu ma 28 warstw (Qwen3-0.6B-Base). Położenie punktów jest poglądowe. Kadr z odcinka.
Po ostatniej warstwie interesuje nas jedna kartka: ta na samym końcu twojego zdania. Tylko ona widziała wszystkie wcześniejsze, więc jej współrzędne niosą informację z całego zdania. Maszyna porównuje je ze wzorcem każdej kartki ze słownika. Im lepiej pasują, tym wyższa ocena.
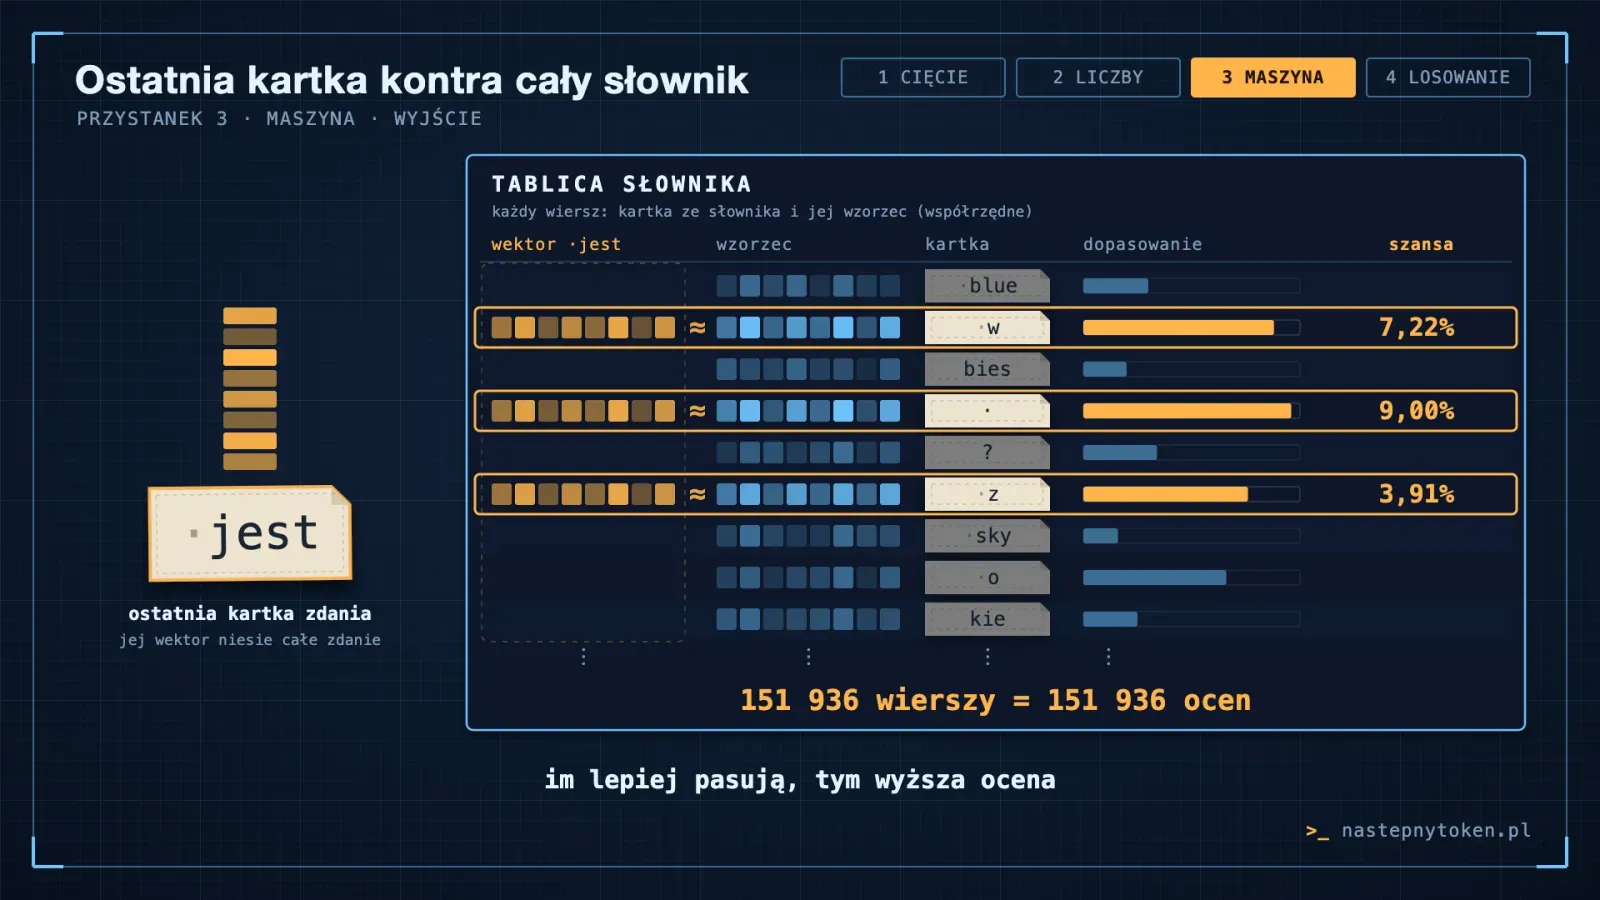 Animacja · przesuń suwak
Co dalej? Kto jest następny w kolejce?
Przystanek 4a: rozkład prawdopodobieństw, po polsku i po angielsku
I tu jest sedno. Maszyna nie mówi: następne słowo to takie a takie. Maszyna wystawia ocenę każdemu kawałkowi ze słownika, wszystkim naraz. W modelu, który tu pokazuję, to ponad sto pięćdziesiąt tysięcy kandydatów. Liczyłem to na małym, otwartym modelu, bo takiego mogę uruchomić u siebie i zajrzeć do środka. Te liczby pochodzą z małego modelu, nie z ChatGPT. Oceny zamienia na prawdopodobieństwa wzór o nazwie softmax. Wszystkie razem dają sto procent.
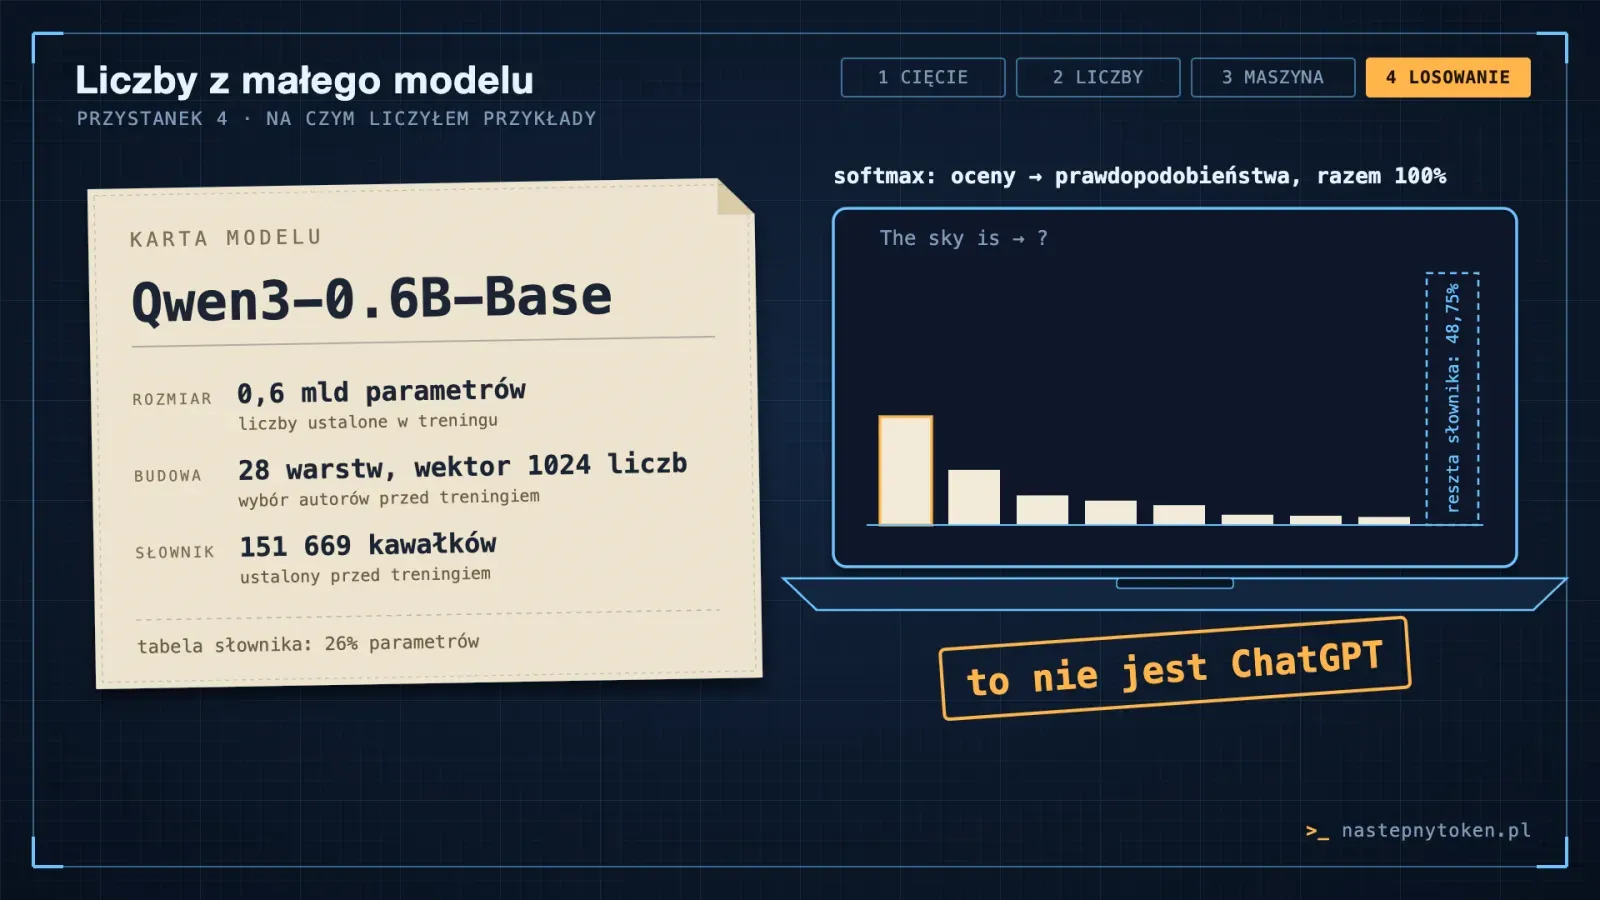
Karta modelu z przykładu. Liczby parametrów da się sprawdzić skryptem: eksperyment o parametrach modelu. Kadr z odcinka.
Ten model ma własny słownik. To samo zdanie tnie na jedenaście kartek, nie dziewięć, i prawie każda ma tu inny numer.
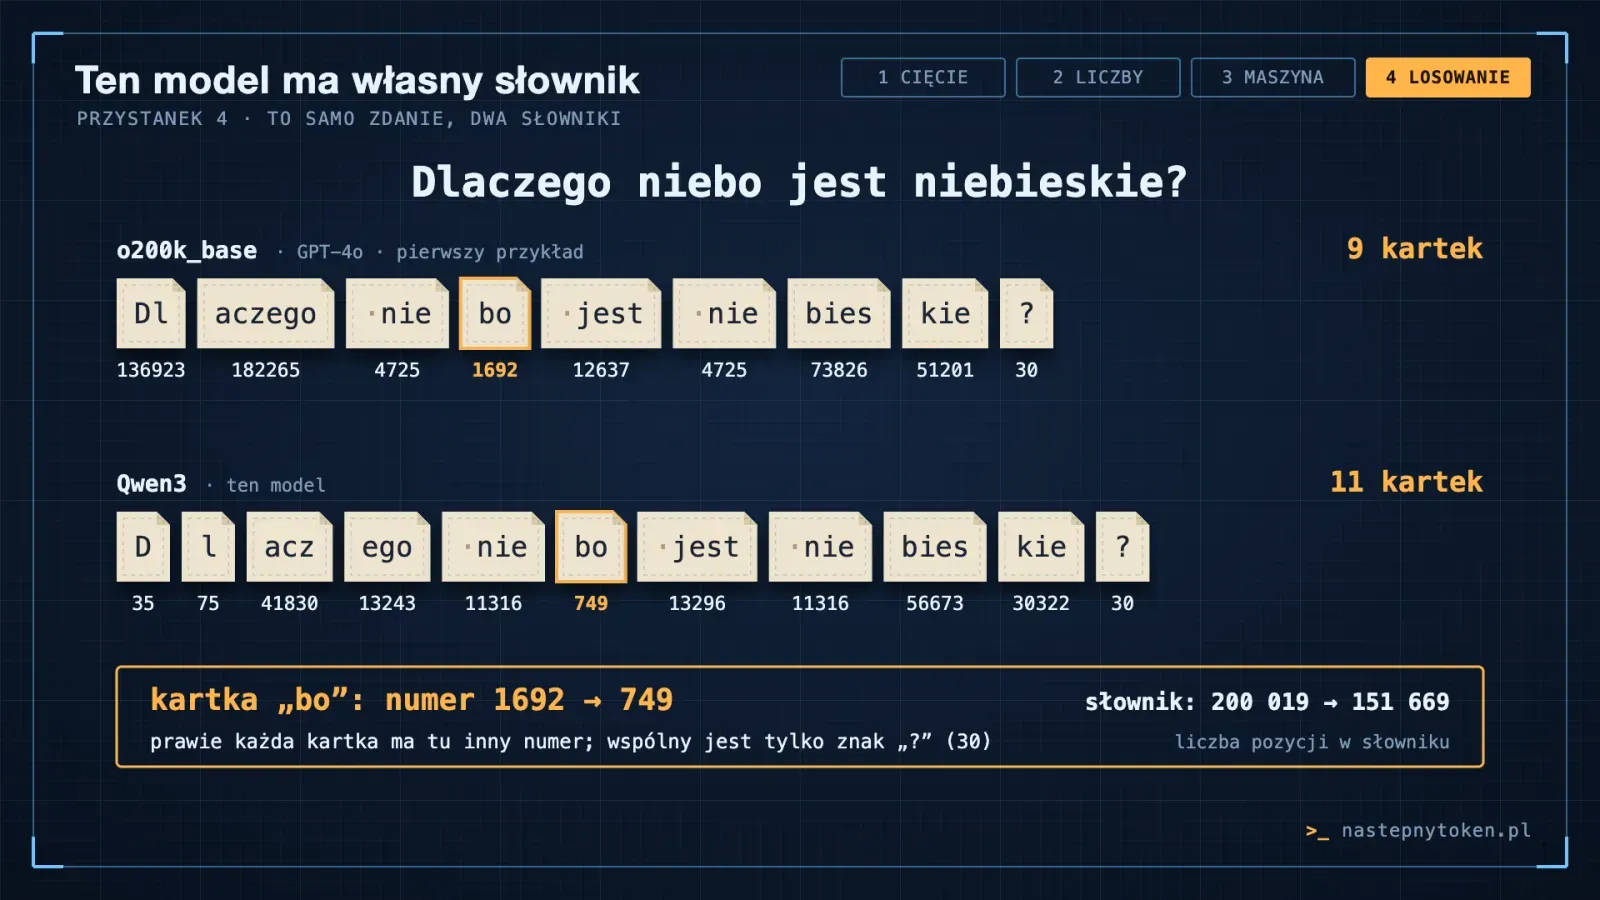
Dwa słowniki, dwa podziały, dwa zestawy numerów. Kadr z odcinka.
Zobacz to na tym samym pytaniu, po angielsku i po polsku. Po angielsku: the sky is. Najwyższy słupek ma blue, prawie dwadzieścia jeden procent, a osiem pierwszych kandydatów razem to ponad połowa.
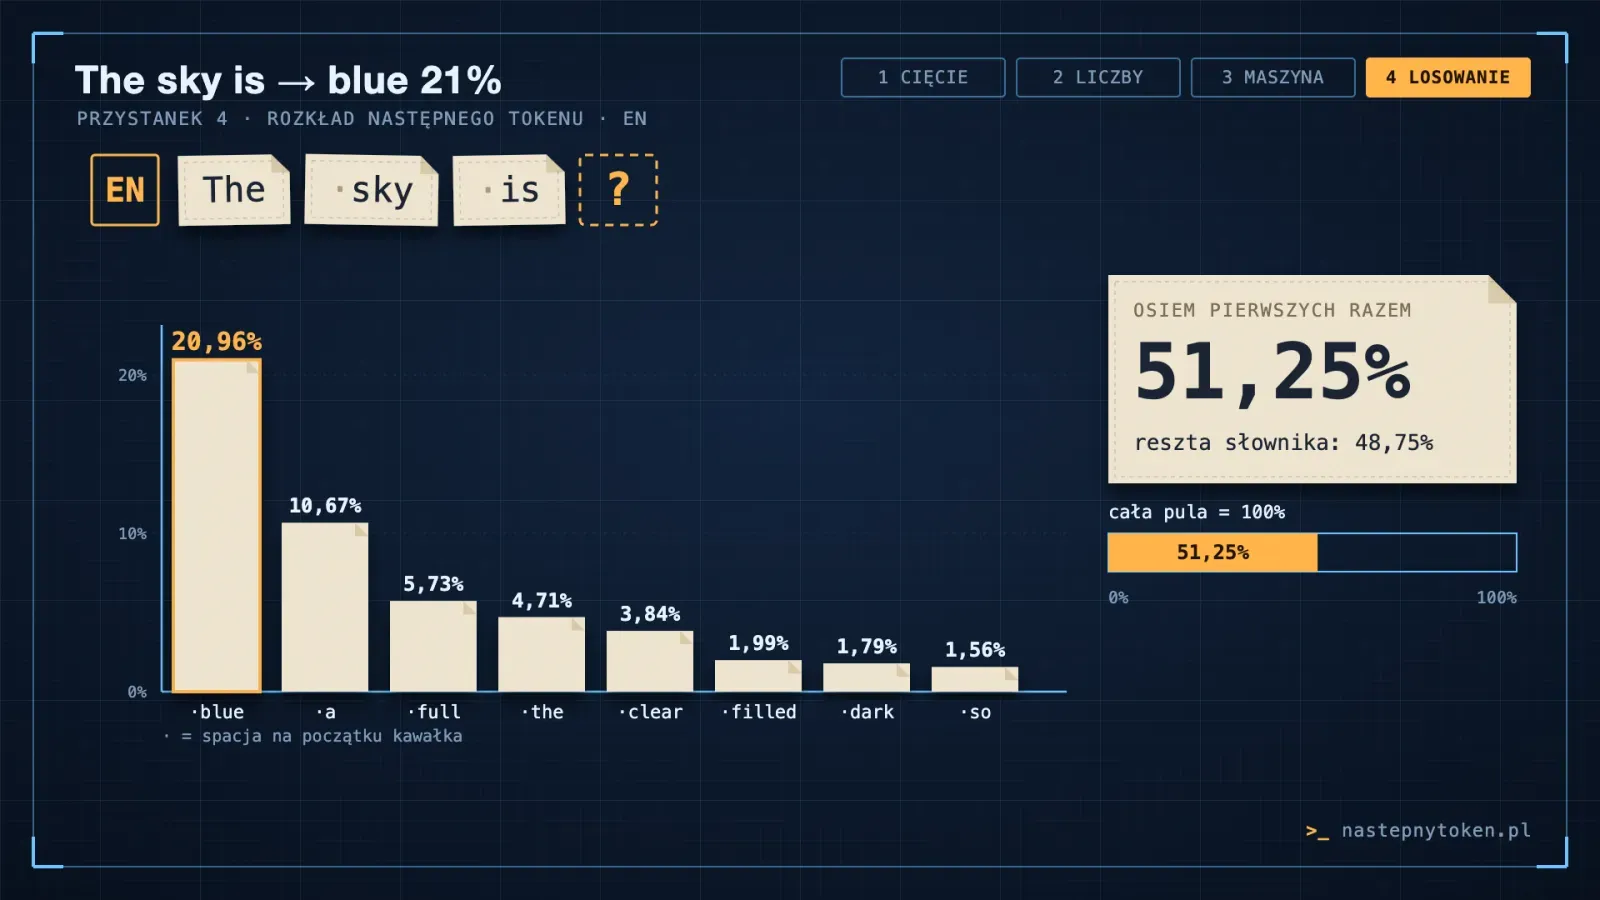
Rozkład po „The sky is” na modelu Qwen3-0.6B-Base (to nie ChatGPT). Kadr z odcinka.
Po polsku: niebo jest. Najwyższy słupek to sama spacja, dziewięć procent, zaraz za nią kartka w, a osiem pierwszych razem daje niecałe trzydzieści procent.
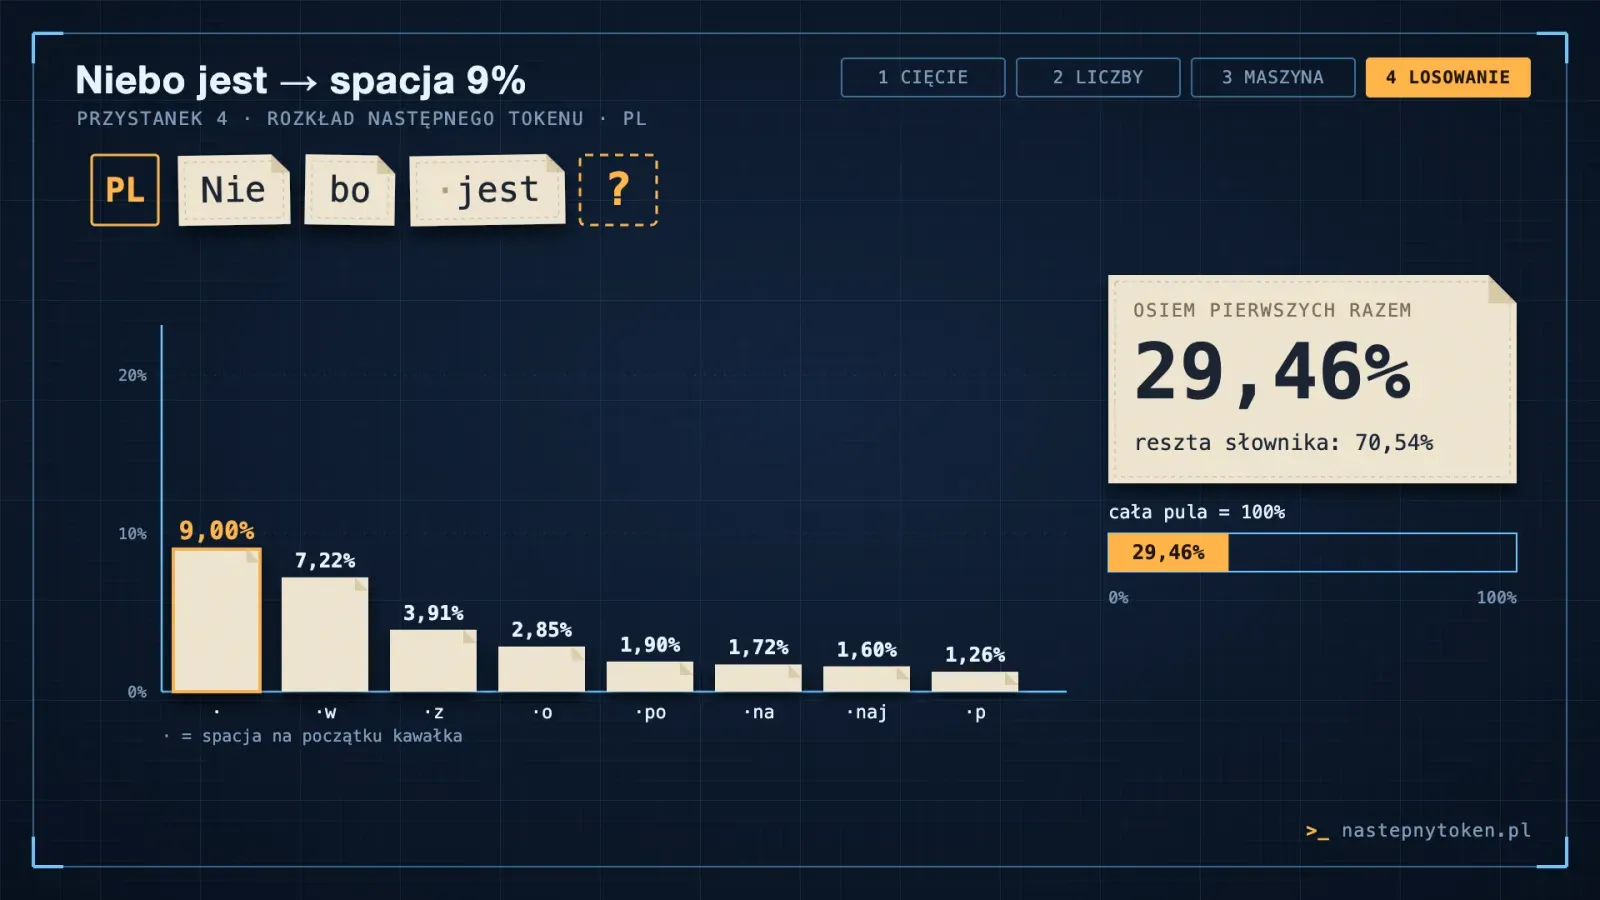
Ten sam model, polskie zdanie: słupki są niższe i bardziej rozproszone. Kadr z odcinka.
Ten sam model, to samo pytanie, a po polsku jest wyraźnie mniej pewny. Pomiar pokazuje różnicę, nie jej przyczynę. To mały model, więc z jednego zdania nie wyciągajmy wniosków o wszystkich modelach. I jeszcze jedno: to nie jest odpowiedź. To jest lista życzeń z wagami. Po polsku ponad siedem tysięcy kandydatów ma szansę większą niż jedna milionowa, po angielsku ponad pięć tysięcy. Reszta słownika nie ma zera. Ten wzór nigdy zera nie daje. Zapamiętaj ten ogonek, bo zaraz zobaczysz, do czego służy.
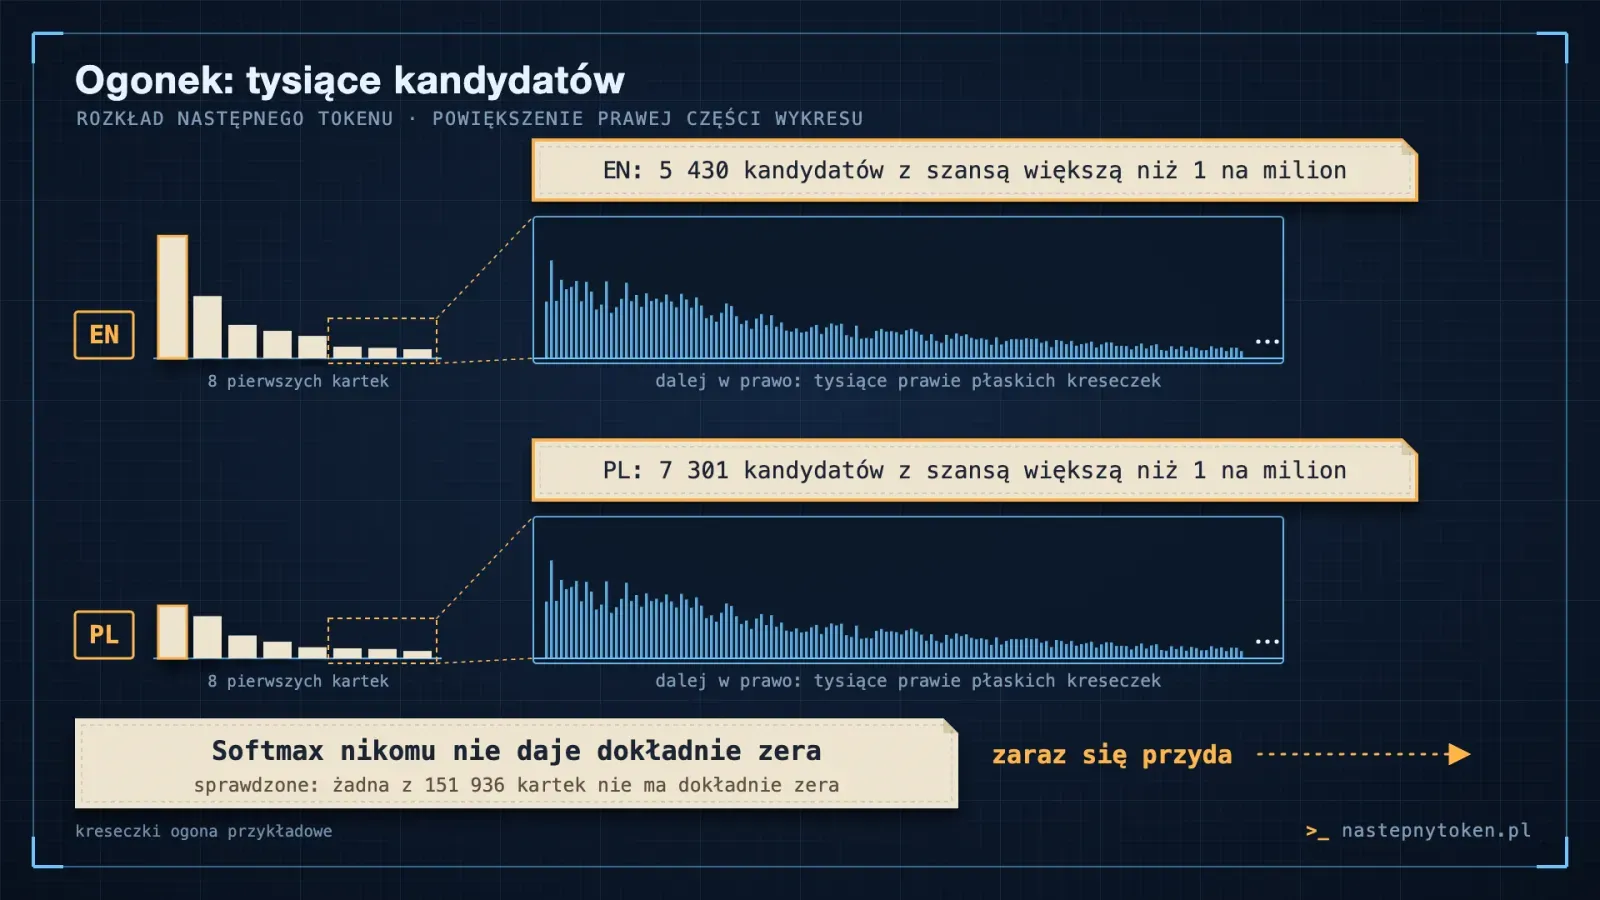
Ogonek rozkładu. Sprawdzenie, że żadna z 151 936 wartości nie jest zerem: eksperyment o zerze w softmaksie. Kadr z odcinka.
Przystanek 4b: losowanie i temperatura
No dobrze, ale skąd bierze się wybór? Wyobraź sobie worek, w którym każdy kandydat ma tyle kartek, ile wynosi jego prawdopodobieństwo. Maszyna sięga do worka i losuje jedną. To jest losowanie. Chcesz losować sam? Przejdź od razu do testu na żywo.
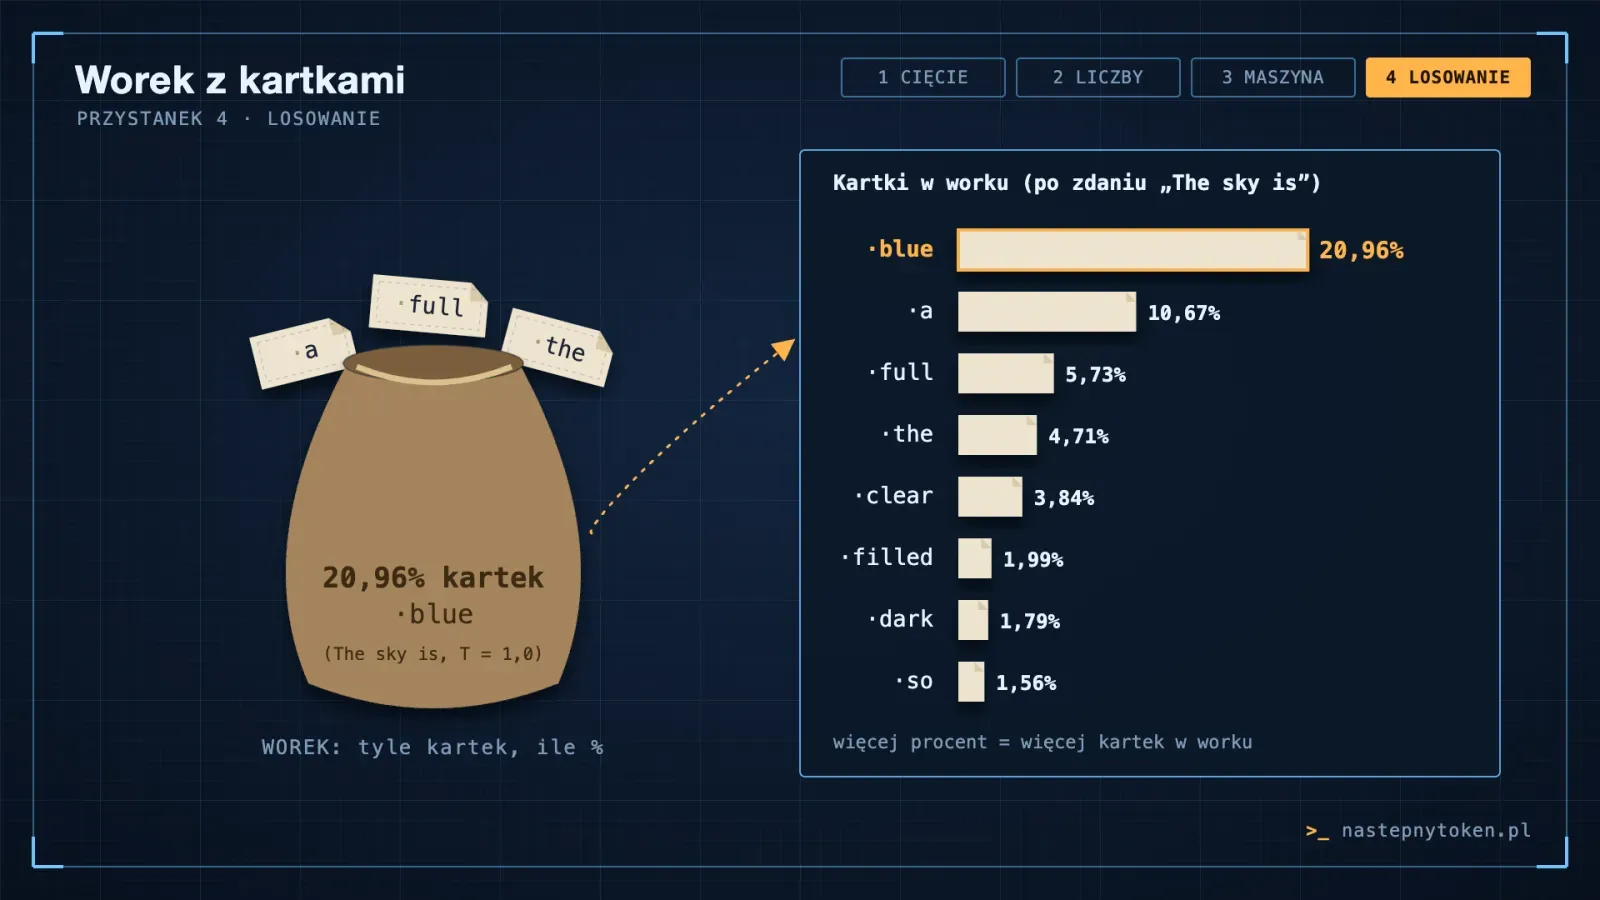
Losowanie z worka, w którym każda kartka to szansa jednego kandydata. Kadr z odcinka.
Dlatego to samo pytanie, zadane dwa razy, może dać dwie różne odpowiedzi. Nie dlatego, że maszyna zmieniła zdanie. Dlatego, że wylosowała inną kartkę.
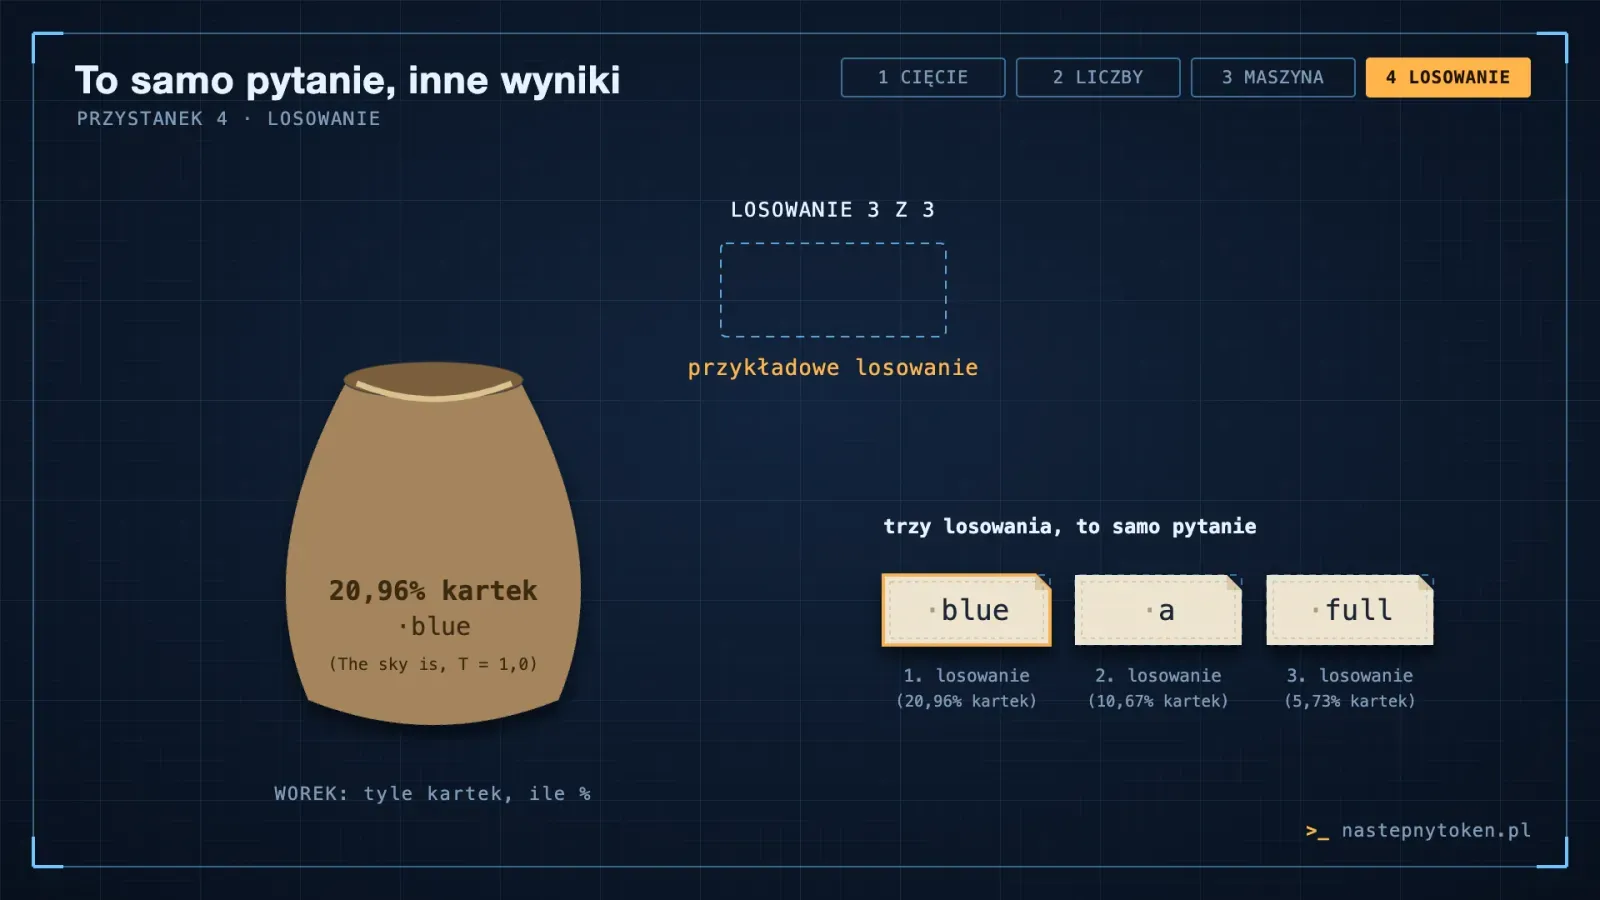 Animacja · przesuń suwak
Sam rozkład jest za każdym razem policzony tak samo. Losowość pojawia się dopiero tutaj. A teraz pokrętło. Nazywa się temperatura. To dzielnik, przez który przechodzą oceny, zanim zamienią się w prawdziwe prawdopodobieństwa.
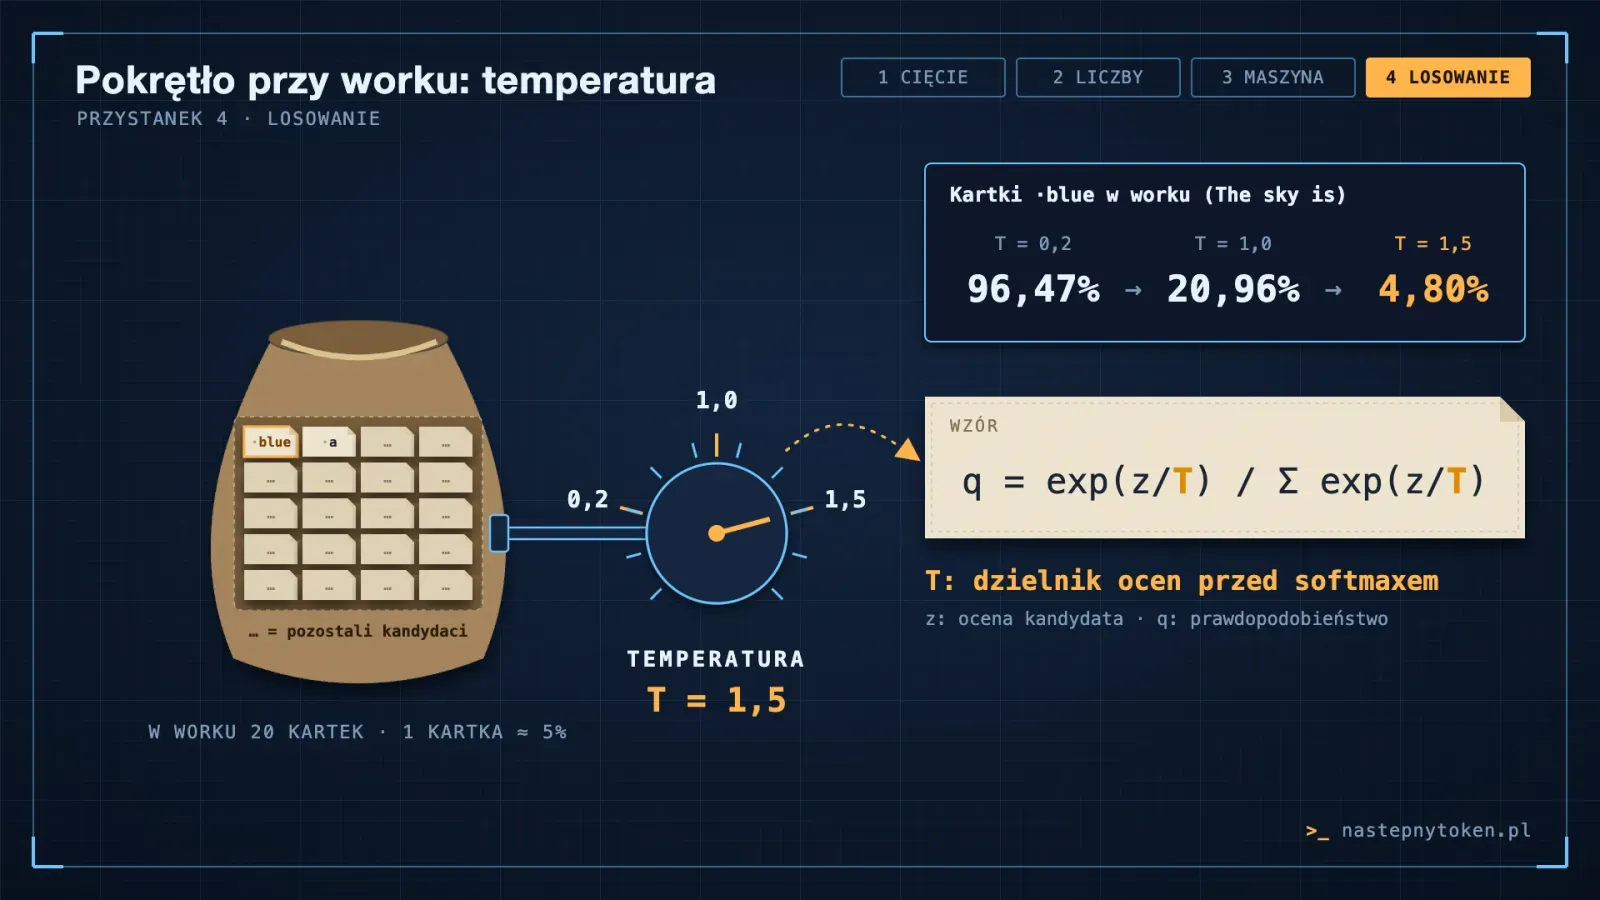 Animacja · przesuń suwak
Zmierzyłem to na tych samych dwóch zdaniach. Po angielsku blue ma przy temperaturze jeden prawie dwadzieścia jeden procent, przy zero i dwóch dziesiątych prawie dziewięćdziesiąt siedem, a przy jeden i pół spada do niecałych pięciu. Po polsku najwyższa kartka ma przy temperaturze jeden dziewięć procent, przy zero i dwóch dziesiątych prawie siedemdziesiąt cztery, a przy jeden i pół niecałe dwa. Wyższa temperatura to łagodniejszy rozkład, więc w worku robi się więcej szans dla outsiderów: przy jeden i pół szansę większą niż jedna milionowa ma ponad dwadzieścia tysięcy kandydatów.
Odpowiedzi są bardziej zaskakujące. Czasem w złym sensie. Kręć sobie.
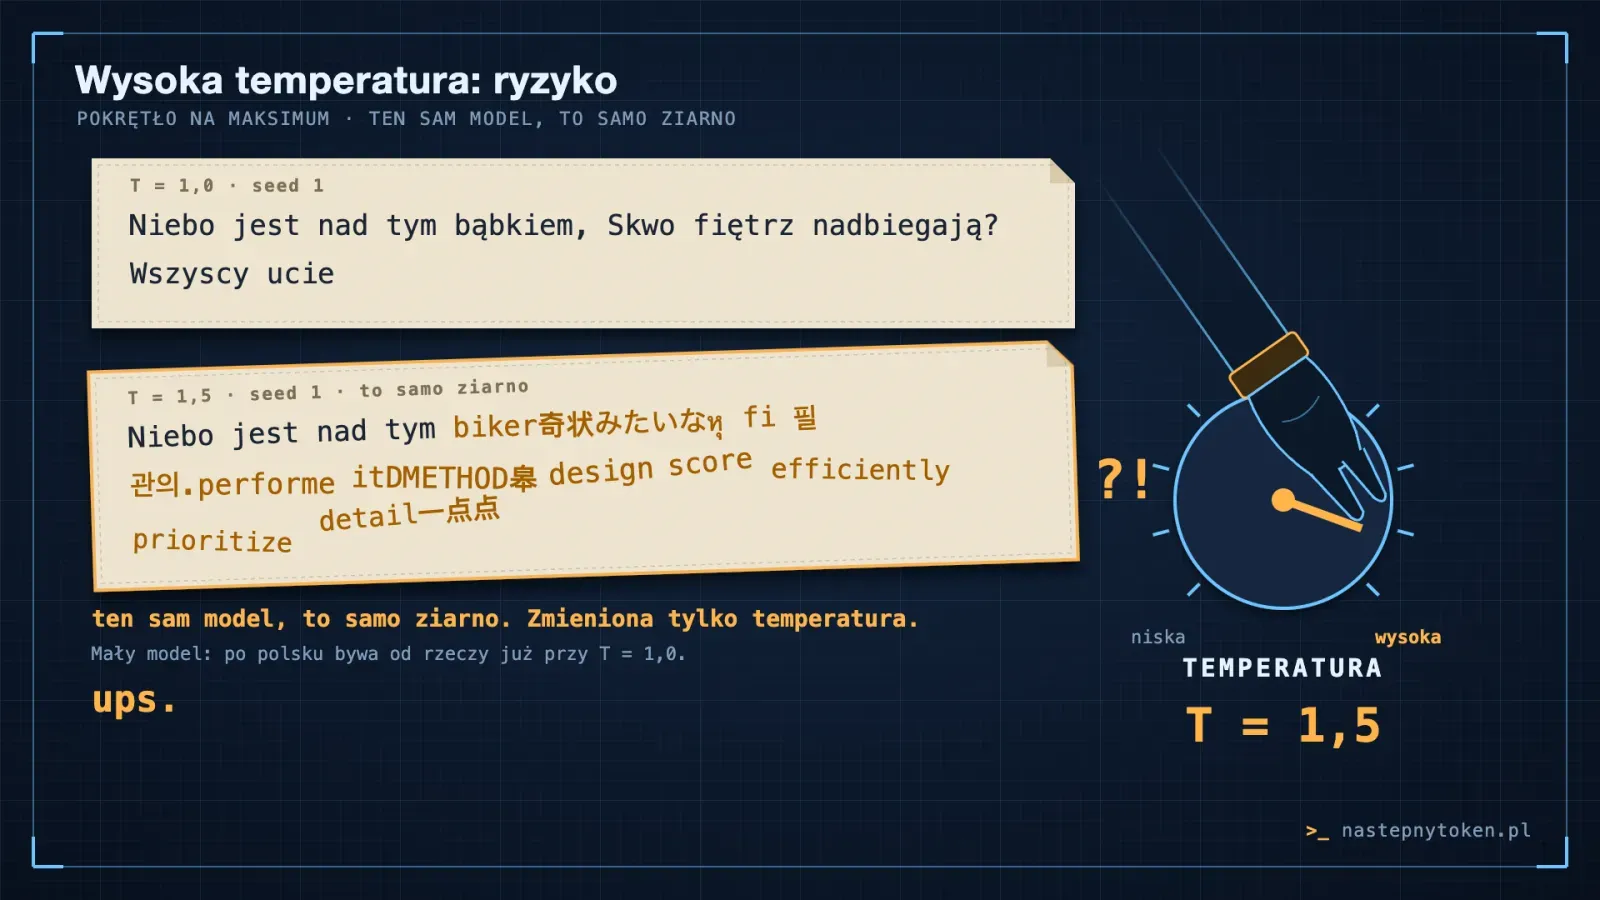 Animacja · przesuń suwak
Teraz Twoja kolej. W teście na żywo wybierzesz zdanie i temperaturę, a model dopisze resztę.
Test na żywo: jak model wybiera następny kawałek tekstu?
Model nie zna odpowiedzi z góry. Dla każdego możliwego następnego kawałka tekstu (to właśnie token: całe słowo albo jego początek) liczy szansę, a potem losuje jeden kawałek zgodnie z tymi szansami i dopisuje kolejne tą samą metodą. Poniżej prawdziwe szanse i prawdziwe zdania wygenerowane przez mały model. Przejdź trzy kroki.
1Wybierz początek zdania
2Ustaw śmiałość modelu (temperaturę)
T = 1,0 (neutralnie): szanse są takie, jak je policzył model.
3Wylosuj i zobacz zdanie
Kliknij „Losuj”. Pierwszy wylosowany kawałek będzie podświetlony, a resztę zdania model dopisze sam.
Dane: model Qwen/Qwen3-0.6B-Base (to nie ChatGPT), pomiar 9 października 2026, jedno zdanie na jednym małym modelu, więc nie wyciągaj z tego wniosków o wszystkich modelach. Słupki to zmierzone szanse pierwszego kawałka. Przycisk „Losuj” pokazuje jedną z prawdziwych próbek wygenerowanych przez ten model dla wybranego zdania i temperatury (po około 300 na każde ustawienie, czyste losowanie bez filtrów Top-K i Top-P, 12 kawałków). Z 1800 próbek usunąłem 23 (1,28%), bo zawierały adresy internetowe, urwane znaki albo słowa wymagające ostrożności, co minimalnie zmienia częstości. Pokazane są tylko trzy temperatury, które faktycznie zmierzono.
Pętla: odpowiedź powstaje token po tokenie
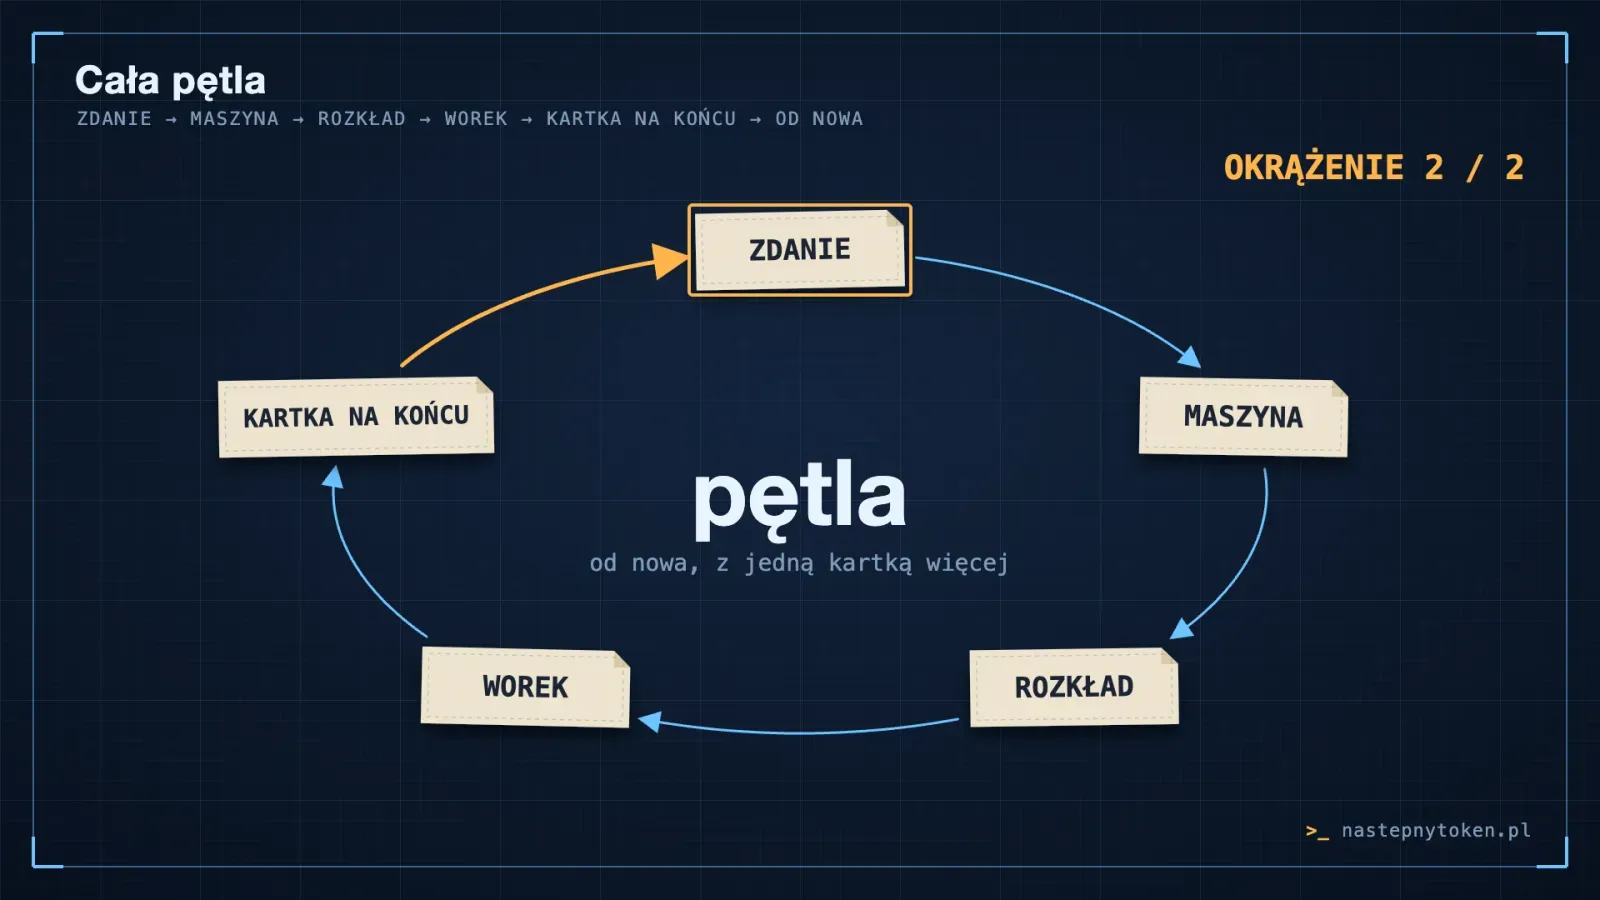
Wylosowany token ląduje na końcu taśmy. Dokładnie tak, jakbyś sam go napisał. I cała maszyna rusza od nowa, z jedną kartką więcej. Nowy rozkład, nowe losowanie, kolejna kartka. I tak w kółko, aż maszyna wylosuje specjalną kartkę, która znaczy: koniec odpowiedzi.
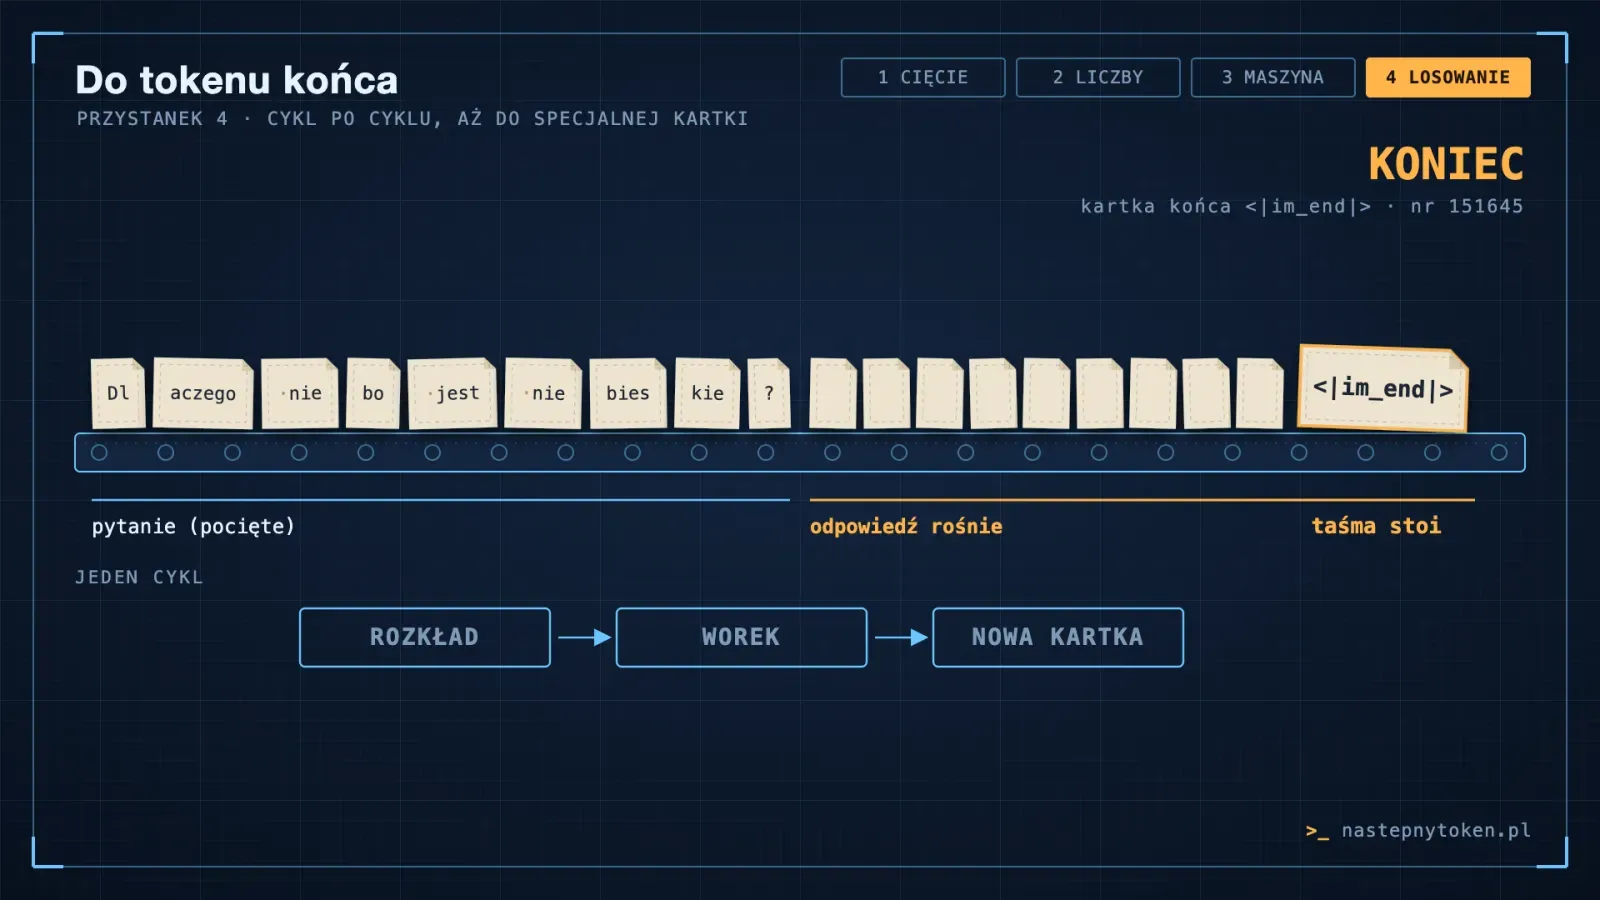 Animacja · przesuń suwak
Ta kartka to zwykła pozycja w słowniku, z własnym numerem. Dostaje ocenę jak każda inna. W środku zdania jej szansa jest prawie zerowa. Zaraz po kropce, która zamyka odpowiedź, skacze do około dziewięćdziesięciu procent. Wtedy program przestaje losować, a samej kartki nie pokazuje. Przy okazji: ta odpowiedź była merytorycznie błędna. Kartka końca pilnuje formy zdania, a nie prawdy. Drugi hamulec to limit długości odpowiedzi.
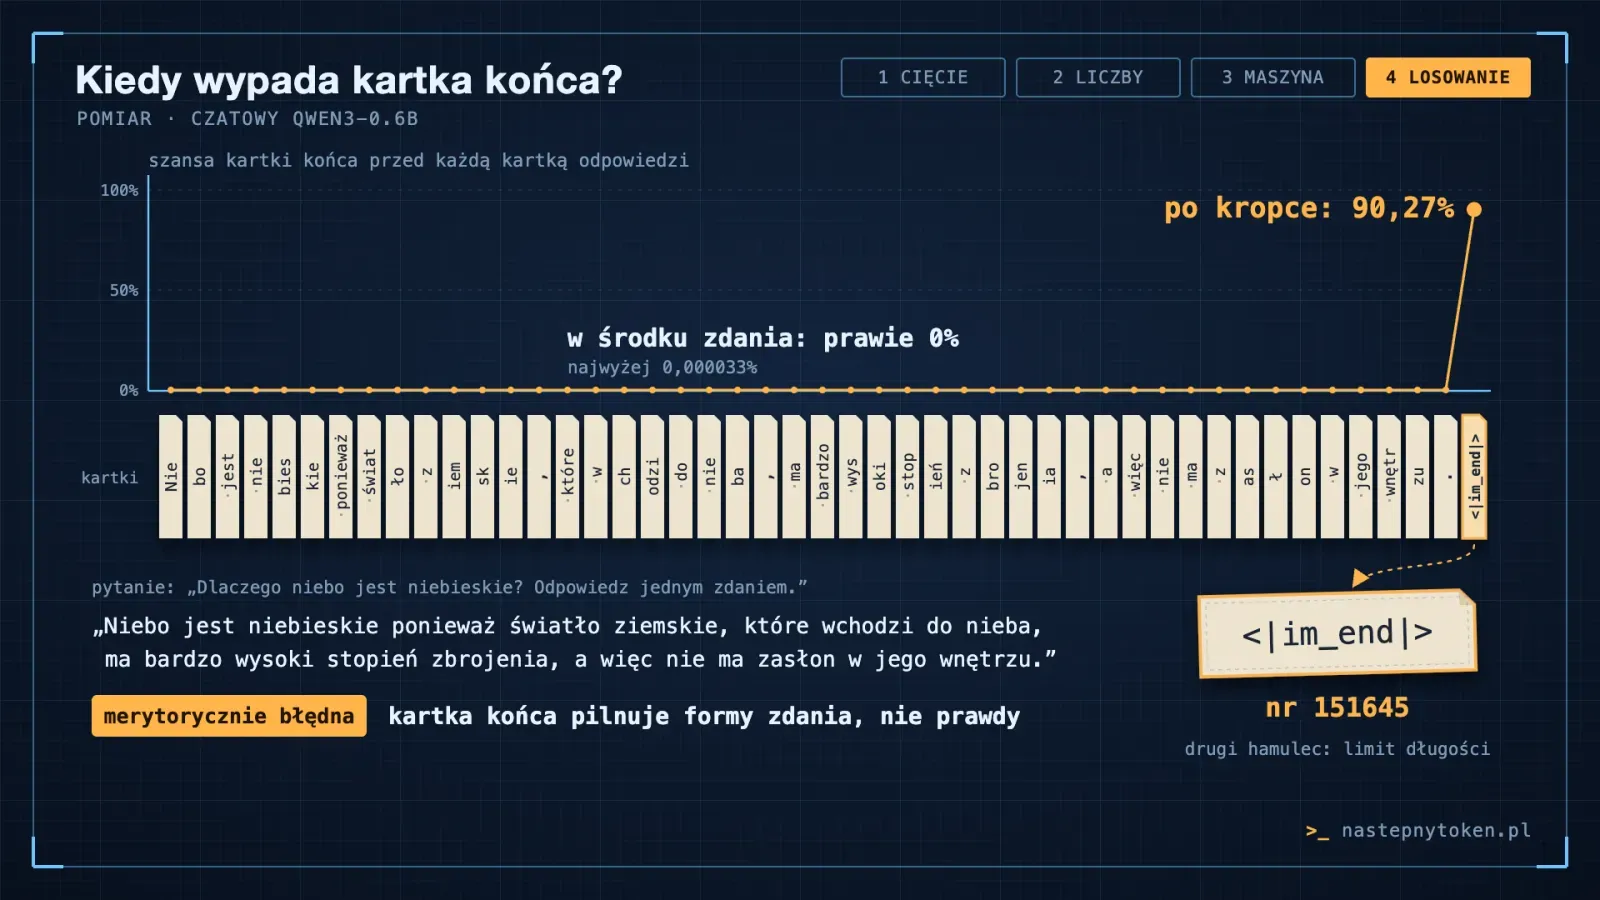
Szansa kartki końca przed każdą kartką odpowiedzi czatowego Qwen3-0.6B: w środku zdania najwyżej 0,000033%, po kropce 90,27%. Pomiar możesz powtórzyć: eksperyment o kartce końca. Kadr z odcinka.
Dlatego odpowiedź pojawia się kawałek po kawałku. To nie tylko efekt wizualny. Ona naprawdę powstaje po kolei, każdy kolejny kawałek zależy od wszystkiego, co już leży na taśmie.
Maszyna nie wyciąga gotowej odpowiedzi z szuflady. Dopisuje ją na bieżąco. I to jest cała pętla.
 Animacja · przesuń suwak
Co uprościłem
Trzy rzeczy, które w tym obrazie uprościłem.
Po pierwsze: losowanie z worka to uproszczenie. W praktyce stosuje się też dodatkowe sztuczki, na przykład ucinanie ogonka rozkładu, żeby nie losować zupełnych dziwactw. Odcięci kandydaci dostają wtedy dokładne zero. Po drugie: twoja rozmowa nie trafia do modelu jako goły tekst. Jest opakowana w znaczniki ról i ukryte instrukcje. Po trzecie, najważniejsze: model nie nauczył się tylko zgadywać następne słowo z internetu. Potem przechodzi dalsze dostrajanie, które uczy go zachowywać się jak asystent. Pętla jest ta sama, ale ułożenie słupków zależy od całego treningu.
Podsumowanie
Zbierzmy to w jeden obraz. Twoje zdanie zostaje pocięte na kartki. Kartki dostają współrzędne. Maszyna ocenia każdego kandydata na następną. Z worka losujemy jedną. Kładziemy ją na końcu. I od nowa. To cała tajemnica.
To samo okno czatu co na początku: teraz wiesz, co się dzieje. Kadr z odcinka.
Każdy kawałek odpowiedzi to jedno losowanie z worka. Każdą liczbę z tego odcinka sprawdzisz sam: przepisy są w sekcji Jak powtórzyć eksperymenty.
Jak powtórzyć eksperymenty
Każda liczba w tym odcinku pochodzi z pomiaru, który możesz powtórzyć u siebie. Poniżej jest po kolei każdy eksperyment z filmu: co sprawdza, jak go uruchomić, nagranie prawdziwego uruchomienia i wynik, który mi wyszedł. Pierwszy nie wymaga nawet Pythona.
Nagrania pokazują prawdziwe uruchomienia skryptów na moim komputerze (Apple M2, bez karty graficznej), zapisane 16 października 2026. Nic w nich nie jest symulowane: terminal rejestruje każdy fragment wyniku razem z czasem. W odtwarzaczu możesz przewijać suwakiem i zaznaczać tekst, a pod każdym nagraniem jest cały wynik jako zwykły tekst. Modele miałem już pobrane, więc u Ciebie pierwsze uruchomienie potrwa dłużej: skrypty pobiorą dwa modele po ok. 1,2 GB.
Przygotowanie (raz)
Potrzebujesz Pythona 3.11 i ok. 4 GB wolnego miejsca (biblioteki ok. 1 GB, dwa modele po ok. 1,2 GB). Wszystkie skrypty, nasze wyniki do porównania i pełne README są w jednej paczce: pomiary-odcinek-1.zip (ok. 100 KB). Kod każdego skryptu możesz też rozwinąć i skopiować prosto z tej strony: bloki „Pokaż kod” są zwinięte.
unzip pomiary-odcinek-1.zip && cd pomiary
python3.11 -m venv venv
source venv/bin/activate          # Windows: venv\Scripts\activate
pip install -r requirements.txt   # Linux bez karty graficznej: dodaj --extra-index-url https://download.pytorch.org/whl/cpu
export HF_HOME=$(mktemp -d)       # modele trafią do katalogu tymczasowego; Windows: set HF_HOME=%TEMP%\hf
export PYTHONUTF8=1               # tylko Windows (set PYTHONUTF8=1)
Wersje bibliotek (requirements.txt) i rewizje modeli (_wspolne.py) są przypięte, więc dostaniesz te same wagi i te same liczby. Po wszystkim usuń katalog HF_HOME. Zamiast pojedynczych poleceń możesz uruchomić całość jednym skryptem: bash uruchom_wszystko.sh --bez-claude. Zapisuje wynik każdego kroku do logi/ i zatrzymuje się na pierwszym błędzie. Poniżej są pliki wspólne dla wszystkich eksperymentów:
Pokaż kod: requirements.txt
annotated-doc==0.0.5
annotated-types==0.8.0
anthropic==1.14.0
anyio==4.15.1
certifi==2026.7.22
charset-normalizer==3.5.2
click==8.5.0
docstring_parser==0.18.0
filelock==4.2.0
fsspec==2026.9.0
h11==0.16.0
hf-xet==1.7.0
httpcore2==2.13.1
httpx2==2.13.1
huggingface_hub==2.2.0
idna==3.20
Jinja2==3.1.6
jiter==0.17.0
markdown-it-py==4.2.0
MarkupSafe==3.0.4
mdurl==0.1.2
mpmath==1.3.0
networkx==3.6.1
numpy==2.4.6
opentelemetry-api==1.45.1
packaging==26.3
pydantic==2.14.1
pydantic_core==2.50.1
Pygments==2.21.0
PyYAML==6.0.3
regex==2026.9.29
requests==2.34.2
rich==15.0.0
safetensors==0.8.0
shellingham==1.5.4
sniffio==1.3.1
sympy==1.14.0
tiktoken==0.14.0
tokenizers==0.23.3
torch==2.14.1
tqdm==4.70.1
transformers==5.19.0
truststore==0.10.5
typer==0.27.3
typing-inspection==0.4.4
typing_extensions==4.16.0
urllib3==2.8.0
Pokaż kod: _wspolne.py
"""Wspólne stałe i funkcje skryptów pomiarowych odcinka 1.

Każdy skrypt zapisuje wynik obok siebie (niezależnie od katalogu, z którego go uruchomiono)
i dokłada klucz "meta": wersje bibliotek, rewizję modelu, platformę i datę przebiegu.
Rewizje modeli są przypięte, żeby ponowny przebieg używał dokładnie tych samych wag.
"""
import datetime, importlib, json, platform
from pathlib import Path

KATALOG = Path(__file__).resolve().parent

MODEL_BAZOWY = "Qwen/Qwen3-0.6B-Base"
REWIZJA_BAZOWY = "da87bfb608c14b7cf20ba1ce41287e8de496c0cd"  # main na Hugging Face od 2025-07-26, użyta w pomiarach 2026-10-09
MODEL_CZAT = "Qwen/Qwen3-0.6B"
REWIZJA_CZAT = "c1899de289a04d12100db370d81485cdf75e47ca"

# Pięć par zdań PL/EN do liczenia tokenów (tok.py, claude_tokeny.py).
PARY_TOK = [
    ("Dlaczego niebo jest niebieskie?", "Why is the sky blue?"),
    ("Wpisujesz pytanie i naciskasz Enter.", "You type a question and press Enter."),
    ("Model zgaduje następny token i dokleja go do odpowiedzi.", "The model guesses the next token and appends it to the answer."),
    ("Prawdopodobieństwo każdego kawałka słownika jest różne.", "The probability of each piece of the vocabulary is different."),
    ("Szybki brązowy lis przeskakuje nad leniwym psem.", "The quick brown fox jumps over the lazy dog."),
]


def meta(**dodatkowe):
    wersje = {}
    for nazwa in ["torch", "transformers", "tokenizers", "tiktoken", "numpy", "huggingface_hub", "safetensors"]:
        try:
            wersje[nazwa] = importlib.import_module(nazwa).__version__
        except ImportError:
            pass
    m = {"data": datetime.datetime.now().astimezone().isoformat(timespec="seconds"),
         "python": platform.python_version(), "platforma": platform.platform(), "procesor": platform.machine(),
         "wersje": wersje}
    if "torch" in wersje:
        import torch
        m["watki_torch"] = torch.get_num_threads()
    m.update(dodatkowe)
    return m


def zapisz_json(sciezka, dane, **opcje):
    """Zapis w UTF-8; względna ścieżka liczy się od katalogu pomiarów."""
    sciezka = Path(sciezka)
    if not sciezka.is_absolute():
        sciezka = KATALOG / sciezka
    opcje.setdefault("indent", 1)
    with open(sciezka, "w", encoding="utf-8") as f:
        json.dump(dane, f, ensure_ascii=False, **opcje)
    print(f"zapisano {sciezka.name}")


def wczytaj_json(sciezka):
    sciezka = Path(sciezka)
    if not sciezka.is_absolute():
        sciezka = KATALOG / sciezka
    with open(sciezka, encoding="utf-8") as f:
        return json.load(f)
Pokaż kod: uruchom_wszystko.sh
#!/usr/bin/env bash
# Uruchamia wszystkie pomiary odcinka 1 po kolei i zapisuje wynik każdego kroku do logi/<skrypt>.log.
#   bash uruchom_wszystko.sh              # wszystko, łącznie z Claude (potrzebny klucz, patrz README)
#   bash uruchom_wszystko.sh --bez-claude # bez claude_tokeny.py
# Python: zmienna PYTHON (domyślnie python3 z aktywnego środowiska). Paski postępu ładowania wag są pomijane w logach.
set -euo pipefail
cd "$(dirname "$0")"
PY="${PYTHON:-python3}"
mkdir -p logi
KROKI=(tok spacja slowniki pairs losowanie probki_lab filtruj_probki rozklad parametry koniec claude_tokeny sprawdz)
for k in "${KROKI[@]}"; do
  if [ "$k" = "claude_tokeny" ] && [ "${1:-}" = "--bez-claude" ]; then continue; fi
  echo "== $k ($(date +%H:%M:%S))"
  echo "\$ python $k.py" > "logi/$k.log"
  set +e
  "$PY" "$k.py" 2>&1 | tr '\r' '\n' | grep -v -E "Loading weights|it/s\]|s/it\]|^\s*$|unauthenticated requests to the HF Hub" >> "logi/$k.log"
  kod=${PIPESTATUS[0]}
  set -e
  tail -n 3 "logi/$k.log"
  if [ "$kod" -ne 0 ]; then echo "BŁĄD: $k.py zakończył się kodem $kod (pełny wynik: logi/$k.log)"; exit "$kod"; fi
done
rm -rf __pycache__
1. Cięcie zdania na tokeny, w przeglądarce
Co sprawdza. Czy zdanie z filmu naprawdę tnie się na dziewięć kartek o tych samych numerach, a angielski odpowiednik na sześć.
Jak uruchomić. Otwórz tiktokenizer.vercel.app, wybierz o200k_base (nie gpt-4o, bo wtedy narzędzie dokleja szablon czatu) i wpisz całe zdanie, ze spacjami. Zaznacz „Show whitespace”, żeby spację zobaczyć jako kropkę.
Wynik. „Dlaczego niebo jest niebieskie?” to 9 tokenów o numerach 136923, 182265, 4725, 1692, 12637, 4725, 73826, 51201, 30. „Why is the sky blue?” to 6 tokenów: 13903, 382, 290, 17307, 9861, 30. Numer 4725 pojawia się dwa razy, bo to ta sama kartka „nie” (ze spacją) w słowach „niebo” i „niebieskie”.
2. Ile tokenów zajmuje polski, a ile angielski
Co sprawdza. Liczbę tokenów w pięciu parach zdań (to samo po polsku i po angielsku) w dwóch słownikach OpenAI: o200k_base (GPT-4o) i cl100k_base (GPT-4, GPT-3.5). Do tego numery kartek słów „truskawka”, „kot” i „czajnik”.
python tok.pyPokaż kod: tok.py
"""Liczba tokenów w 5 parach zdań PL/EN (scena 3) i numery tokenów pokazywane w filmie.

Słowniki: o200k_base (GPT-4o) i cl100k_base (GPT-4, GPT-3.5-turbo), biblioteka tiktoken.
Uruchomienie: python tok.py   (tiktoken 0.14.0). Wynik: tok.json
"""
import tiktoken
from _wspolne import PARY_TOK, meta, zapisz_json

# Pojedyncze słowa z filmu: truskawka (ujęcie 18), kot i czajnik (ujęcie 19). Spacja przed słowem zmienia numer.
SLOWA = ["truskawka", "strawberry", "kot", " kot", "Kot", "czajnik", " czajnik"]
MODELE = ["gpt-4o", "gpt-4", "gpt-3.5-turbo"]

out = {"meta": meta(), "kodowania": {}, "encoding_for_model": {}}
for name in ["cl100k_base", "o200k_base"]:
    enc = tiktoken.get_encoding(name)
    print(f"== {name}: n_vocab={enc.n_vocab}")
    k = {"n_vocab": enc.n_vocab, "pary": [], "slowa": {}}
    totpl = toten = 0
    for pl, en in PARY_TOK:
        a, b = enc.encode(pl), enc.encode(en)
        totpl += len(a); toten += len(b)
        k["pary"].append({"pl": {"tekst": pl, "n": len(a), "id": a, "tokeny": [enc.decode([t]) for t in a]},
                          "en": {"tekst": en, "n": len(b), "id": b, "tokeny": [enc.decode([t]) for t in b]}})
        print(f"PL {len(a):2d} tok | {len(pl):2d} zn | {[enc.decode([t]) for t in a]}")
        print(f"EN {len(b):2d} tok | {len(en):2d} zn | {[enc.decode([t]) for t in b]}")
    k.update({"suma_pl": totpl, "suma_en": toten, "stosunek": round(totpl / toten, 2)})
    print(f"SUMA PL={totpl} EN={toten} stosunek={totpl/toten:.2f}")
    print("IDs:", enc.encode(PARY_TOK[0][0]))
    for s in SLOWA:
        ids = enc.encode(s)
        k["slowa"][s] = {"id": ids, "tokeny": [enc.decode([i]) for i in ids]}
    out["kodowania"][name] = k
for m in MODELE:
    out["encoding_for_model"][m] = tiktoken.encoding_for_model(m).name
print("slowa o200k_base:", {s: v["id"] for s, v in out["kodowania"]["o200k_base"]["slowa"].items()})
print("encoding_for_model:", out["encoding_for_model"])
zapisz_json("tok.json", out)Cały wynik jako tekst (do skopiowania)
$ python tok.py
== cl100k_base: n_vocab=100277
PL 11 tok | 31 zn | ['D', 'l', 'acz', 'ego', ' nie', 'bo', ' jest', ' nie', 'bies', 'kie', '?']
EN  6 tok | 20 zn | ['Why', ' is', ' the', ' sky', ' blue', '?']
PL 13 tok | 36 zn | ['W', 'pis', 'uj', 'esz', ' pyt', 'anie', ' i', ' n', 'ac', 'isk', 'asz', ' Enter', '.']
EN  8 tok | 36 zn | ['You', ' type', ' a', ' question', ' and', ' press', ' Enter', '.']
PL 17 tok | 56 zn | ['Model', ' zg', 'ad', 'uje', ' nast', 'ęp', 'ny', ' token', ' i', ' dok', 'le', 'ja', ' go', ' do', ' odpowied', 'zi', '.']
EN 14 tok | 62 zn | ['The', ' model', ' guesses', ' the', ' next', ' token', ' and', ' app', 'ends', ' it', ' to', ' the', ' answer', '.']
PL 23 tok | 55 zn | ['P', 'raw', 'd', 'op', 'od', 'ob', 'ie', 'ńst', 'wo', ' każ', 'de', 'go', ' k', 'awa', 'ł', 'ka', ' sł', 'own', 'ika', ' jest', ' róż', 'ne', '.']
EN 11 tok | 61 zn | ['The', ' probability', ' of', ' each', ' piece', ' of', ' the', ' vocabulary', ' is', ' different', '.']
PL 20 tok | 48 zn | ['S', 'zy', 'b', 'ki', ' br', 'ą', 'z', 'owy', ' lis', ' prz', 'esk', 'aku', 'je', ' nad', ' len', 'iw', 'ym', ' p', 'sem', '.']
EN 10 tok | 44 zn | ['The', ' quick', ' brown', ' fox', ' jumps', ' over', ' the', ' lazy', ' dog', '.']
SUMA PL=84 EN=49 stosunek=1.71
IDs: [35, 75, 42930, 13546, 11568, 754, 13599, 11568, 57773, 31422, 30]
== o200k_base: n_vocab=200019
PL  9 tok | 31 zn | ['Dl', 'aczego', ' nie', 'bo', ' jest', ' nie', 'bies', 'kie', '?']
EN  6 tok | 20 zn | ['Why', ' is', ' the', ' sky', ' blue', '?']
PL 11 tok | 36 zn | ['W', 'pis', 'ujesz', ' pyt', 'anie', ' i', ' nac', 'isk', 'asz', ' Enter', '.']
EN  8 tok | 36 zn | ['You', ' type', ' a', ' question', ' and', ' press', ' Enter', '.']
PL 16 tok | 56 zn | ['Model', ' zg', 'adu', 'je', ' następ', 'ny', ' token', ' i', ' dok', 'le', 'ja', ' go', ' do', ' odpowied', 'zi', '.']
EN 14 tok | 62 zn | ['The', ' model', ' guesses', ' the', ' next', ' token', ' and', ' app', 'ends', ' it', ' to', ' the', ' answer', '.']
PL 16 tok | 55 zn | ['P', 'rawd', 'op', 'odob', 'ień', 'stwo', ' każdego', ' kawa', 'ł', 'ka', ' sł', 'ownika', ' jest', ' róż', 'ne', '.']
EN 11 tok | 61 zn | ['The', ' probability', ' of', ' each', ' piece', ' of', ' the', ' vocabulary', ' is', ' different', '.']
PL 20 tok | 48 zn | ['S', 'zy', 'b', 'ki', ' br', 'ą', 'z', 'owy', ' lis', ' prz', 'esk', 'aku', 'je', ' nad', ' len', 'iw', 'ym', ' p', 'sem', '.']
EN 10 tok | 44 zn | ['The', ' quick', ' brown', ' fox', ' jumps', ' over', ' the', ' lazy', ' dog', '.']
SUMA PL=72 EN=49 stosunek=1.47
IDs: [136923, 182265, 4725, 1692, 12637, 4725, 73826, 51201, 30]
slowa o200k_base: {'truskawka': [371, 26604, 1134, 1854], 'strawberry': [302, 1618, 19772], 'kot': [74443], ' kot': [15066], 'Kot': [180929], 'czajnik': [196046, 9111], ' czajnik': [17136, 1255, 9111]}
encoding_for_model: {'gpt-4o': 'o200k_base', 'gpt-4': 'cl100k_base', 'gpt-3.5-turbo': 'cl100k_base'}
zapisano tok.jsonWynik.
| Słownik | Polski | Angielski | Stosunek |
|---|---|---|---|
o200k_base (GPT-4o), 200 019 pozycji | 72 | 49 | 1,47 |
cl100k_base (GPT-4, GPT-3.5), 100 277 pozycji | 84 | 49 | 1,71 |
Polskie wersje potrzebowały więc średnio ok. 1,5 raza więcej tokenów. To pięć par zdań, czyli mała próbka, nie reguła. Słowa z filmu w o200k_base: „truskawka” to 4 tokeny (tr, usk, aw, ka o numerach 371, 26604, 1134, 1854), „strawberry” to 3 (302, 1618, 19772), „kot” bez spacji to 74443, „ kot” ze spacją 15066, „Kot” wielką literą 180929, „czajnik” to 2 tokeny (196046, 9111). Skrypt sprawdza też, że gpt-4o używa kodowania o200k_base.
3. Czy spacja należy do kartki
Co sprawdza. Czy „ nie” (ze spacją przed słowem), „nie” (bez spacji) i „Nie” (wielką literą) to ta sama kartka. Od tego zależy, czy numer, który zobaczysz, zgodzi się z moim.
python spacja.pyPokaż kod: spacja.py
"""Czy spacja należy do tokenu? Odcinek 1, ujęcie 12b.

W słowniku o200k_base (GPT-4o) " nie" (ze spacją przed słowem) i "nie" (bez spacji) to dwa różne tokeny,
więc mają różne numery. Skrypt zapisuje wynik w spacja.json (tiktoken 0.14.0).
Uruchomienie: python spacja.py
"""
import tiktoken
from _wspolne import meta, zapisz_json

enc = tiktoken.get_encoding("o200k_base")
res = {"meta": meta(), "tiktoken": tiktoken.__version__, "encoding": "o200k_base", "n_vocab": enc.n_vocab, "teksty": {}}
for s in [" nie", "nie", "Nie", "Dlaczego niebo jest niebieskie?"]:
    ids = enc.encode(s)
    res["teksty"][s] = {"id": ids, "tokeny": [enc.decode([i]) for i in ids]}
    print(f"{s!r}: {ids} -> {[enc.decode([i]) for i in ids]}")
res["decode_4725"] = enc.decode([4725])
zapisz_json("spacja.json", res)Cały wynik jako tekst (do skopiowania)
$ python spacja.py
' nie': [4725] -> [' nie']
'nie': [7640] -> ['nie']
'Nie': [52228] -> ['Nie']
'Dlaczego niebo jest niebieskie?': [136923, 182265, 4725, 1692, 12637, 4725, 73826, 51201, 30] -> ['Dl', 'aczego', ' nie', 'bo', ' jest', ' nie', 'bies', 'kie', '?']
zapisano spacja.jsonWynik. Ze spacją przed słowem to token 4725, bez spacji 7640, a z wielką literą 52228. To trzy różne tokeny, dlatego w tokenizerze trzeba wpisywać całe zdanie.
4. Ile tokenów zużywa Claude
Co sprawdza. Te same pięć par zdań, policzone tokenizerem Claude Opus 5.5. Firmy nie ujawniają, ile polskiego jest w danych najnowszych modeli, więc zamiast zgadywać, liczę tokeny.
Jak uruchomić. Skrypt potrzebuje jednego z kluczy: OPENROUTER_API_KEY (płatne, ok. 1–2 centów za cały pomiar, OpenRouter podaje liczbę tokenów liczoną tokenizerem samego modelu) albo ANTHROPIC_API_KEY (oficjalny licznik count_tokens jest darmowy, ale konto w Claude Console musi mieć dodatnie saldo). Klucz ustaw tylko na czas uruchomienia i nie eksportuj klucza Anthropic w powłoce na stałe, bo Claude Code użyłby go zamiast subskrypcji.
OPENROUTER_API_KEY=… python claude_tokeny.pyPokaż kod: claude_tokeny.py
"""Ile tokenów zużywa Claude Opus 5.5 na te same 5 par zdań PL/EN co tok.py? (ujęcie 17)

Dwie drogi, ten sam tokenizer Claude:
1. Klucz Anthropic (ANTHROPIC_API_KEY albo CLAUDE_API_KEY): oficjalny licznik messages.count_tokens.
   Liczenie jest według dokumentacji darmowe, ale konto w Claude Console musi mieć dodatnie saldo.
2. Klucz OpenRouter (OPENROUTER_API_KEY): krótkie wywołanie modelu przez endpoint w formacie Anthropic
   (https://openrouter.ai/api/v1/messages). OpenRouter podaje input_tokens liczone natywnym tokenizerem modelu.
   Płatne: ok. 26 wywołań po kilkanaście tokenów, razem poniżej kilku centów.
Licznik obejmuje zdanie i stałą otoczkę wiadomości (znaczniki roli). Otoczkę K wyznaczamy z kalibracji
na pojedynczych znakach ".", "a", "?": każdy z nich to jeden token (tokenizer bajtowy ma każdy znak ASCII
w słowniku), więc wszystkie trzy muszą dać ten sam wynik, a K = licznik(".") - 1.
Wynik zdania to licznik(zdanie) - K. Każdy tekst liczymy dwa razy.
Uwaga: "hello" nie nadaje się do kalibracji. W nowym tokenizerze Claude (od Opus 4.7) " hello" to 2 tokeny,
co pokazała pierwsza próba (zapisana w polu "hello").

Klucze: zmienne środowiskowe albo wpisy w najbliższym pliku .env w górę od tego katalogu.
Nie eksportuj klucza Anthropic w powłoce na stałe: Claude Code użyłby go zamiast subskrypcji.
Uruchomienie: python claude_tokeny.py   (anthropic 1.14.0). Wynik: claude_tokeny.json
"""
import os
import anthropic
from _wspolne import KATALOG, PARY_TOK, meta, zapisz_json

MODEL = "claude-opus-5-5"
MODEL_OPENROUTER = "anthropic/claude-opus-5.5"
KALIBRACJA = [".", "a", "?"]
HELLO = ["hello", "hello hello", "hello hello hello hello"]


def klucz(*nazwy):
    for nazwa in nazwy:
        if os.environ.get(nazwa):
            return os.environ[nazwa]
    for kat in [KATALOG, *KATALOG.parents]:
        plik = kat / ".env"
        if plik.is_file():
            for linia in plik.read_text(encoding="utf-8").splitlines():
                nazwa, _, wartosc = linia.partition("=")
                if nazwa.strip() in nazwy and wartosc.strip():
                    return wartosc.strip().strip("'\"")
    return None


if k := klucz("ANTHROPIC_API_KEY", "CLAUDE_API_KEY"):
    droga = "Anthropic messages.count_tokens"
    client = anthropic.Anthropic(api_key=k)

    def jeden(tekst):
        return client.messages.count_tokens(model=MODEL, messages=[{"role": "user", "content": tekst}]).input_tokens
elif k := klucz("OPENROUTER_API_KEY"):
    droga = "OpenRouter /api/v1/messages, usage.input_tokens"
    client = anthropic.Anthropic(base_url="https://openrouter.ai/api", api_key=None, auth_token=k)

    def jeden(tekst):
        odp = client.messages.create(model=MODEL_OPENROUTER, max_tokens=16, messages=[{"role": "user", "content": tekst}])
        return odp.usage.input_tokens
else:
    raise SystemExit("Brak klucza: ustaw ANTHROPIC_API_KEY (albo CLAUDE_API_KEY) lub OPENROUTER_API_KEY")
print("droga:", droga)


def licz(tekst):
    wyniki = [jeden(tekst) for _ in range(2)]
    if wyniki[0] != wyniki[1]:
        raise SystemExit(f"różne wyniki dla {tekst!r}: {wyniki}")
    return wyniki[0]


kal = {t: licz(t) for t in KALIBRACJA}
if len(set(kal.values())) != 1:
    raise SystemExit(f"kalibracja: pojedyncze znaki dały różne wyniki {kal}")
K = kal["."] - 1
hello = {t: licz(t) - K for t in HELLO}
print(f"kalibracja {kal}, otoczka K = {K}, hello: {hello}")

pary, spl, sen = [], 0, 0
for pl, en in PARY_TOK:
    a, b = licz(pl) - K, licz(en) - K
    spl += a; sen += b
    pary.append({"pl": {"tekst": pl, "n": a}, "en": {"tekst": en, "n": b}})
    print(f"PL {a:3d} | EN {b:3d} | {pl!r}")
print(f"SUMA PL={spl} EN={sen} stosunek={spl / sen:.2f}")

res = {"meta": meta(model=MODEL, droga=droga, metoda="licznik tokenów wejścia minus otoczka K z kalibracji"),
       "kalibracja": kal, "otoczka_K": K, "hello": hello, "pary": pary, "suma_pl": spl, "suma_en": sen, "stosunek": round(spl / sen, 2)}
zapisz_json("claude_tokeny.json", res)
Licznik dolicza stałą otoczkę wiadomości, więc skrypt ją odejmuje. Wyznacza ją na pojedynczych znakach (., a, ?), z których każdy to dokładnie jeden token: u mnie wszystkie trzy dały 9, czyli otoczka to 8. Każdy tekst jest liczony dwa razy, a skrypt przerywa, gdyby wyniki się różniły.
Cały wynik jako tekst (do skopiowania)
$ OPENROUTER_API_KEY=… python claude_tokeny.py
droga: OpenRouter /api/v1/messages, usage.input_tokens
kalibracja {'.': 9, 'a': 9, '?': 9}, otoczka K = 8, hello: {'hello': 2, 'hello hello': 4, 'hello hello hello hello': 8}
PL  17 | EN   9 | 'Dlaczego niebo jest niebieskie?'
PL  21 | EN  10 | 'Wpisujesz pytanie i naciskasz Enter.'
PL  25 | EN  17 | 'Model zgaduje następny token i dokleja go do odpowiedzi.'
PL  26 | EN  17 | 'Prawdopodobieństwo każdego kawałka słownika jest różne.'
PL  25 | EN  18 | 'Szybki brązowy lis przeskakuje nad leniwym psem.'
SUMA PL=114 EN=71 stosunek=1.61
zapisano claude_tokeny.jsonWynik. Po polsku 114 tokenów, po angielsku 71, czyli o 61% więcej (stosunek 1,61; w o200k_base było 1,47). To samo wyszło 15 października (wtedy też niezależna próba przez Claude Code dała ten sam wynik), więc pomiar jest powtarzalny. Uwaga: tokenizer Claude dzieli drobniej niż o200k_base (słowo „hello” ze spacją to u niego 2 tokeny), a według dokumentacji Anthropic modele od Claude 4.7 mają nowszy tokenizer, który na tym samym tekście daje ok. 30% więcej tokenów niż wcześniejsze. Dlatego w filmie podaję tylko stosunek polskiego do angielskiego, nie bezwzględne liczby.
5. Ile parametrów ma model z przykładów
Co sprawdza. Z czego składa się Qwen3-0.6B-Base: ile ma parametrów, warstw i jaką część zajmuje tabela słownika, czyli „współrzędne kartek”.
python parametry.pyPokaż kod: parametry.py
"""Ile parametrów ma Qwen3-0.6B-Base i ile z nich to współrzędne kartek słownika (ujęcia 32 i 32a).

Liczy parametry modelu (wspólna tabela wejścia i wyjścia liczona raz, bo tie_word_embeddings = true),
odczytuje budowę z config.json i sprawdza, co leży na pozycjach słownika ponad len(tokenizer).
Uruchomienie: python parametry.py   (torch 2.14.1, transformers 5.19.0). Wynik: parametry.json
"""
import torch, warnings
warnings.filterwarnings("ignore")
from transformers import AutoTokenizer, AutoModelForCausalLM
from _wspolne import MODEL_BAZOWY, REWIZJA_BAZOWY, meta, zapisz_json

tok = AutoTokenizer.from_pretrained(MODEL_BAZOWY, revision=REWIZJA_BAZOWY)
model = AutoModelForCausalLM.from_pretrained(MODEL_BAZOWY, revision=REWIZJA_BAZOWY, dtype=torch.float32).eval()
cfg = model.config

razem = sum(p.numel() for p in model.parameters())  # parameters() nie powtarza wspólnej tabeli
emb = model.get_input_embeddings().weight
wspolna = emb.data_ptr() == model.get_output_embeddings().weight.data_ptr()
slownik = emb.numel()

# Pozycje tabeli bez kawałka tekstu w tokenizerze (tabela jest większa niż słownik).
dlugosc = len(tok)
nadmiar = list(range(dlugosc, cfg.vocab_size))
bez_tekstu = [i for i in nadmiar if tok.convert_ids_to_tokens(i) is None]

res = {"meta": meta(model=MODEL_BAZOWY, rewizja=REWIZJA_BAZOWY),
       "config": {k: getattr(cfg, k) for k in ["num_hidden_layers", "hidden_size", "num_attention_heads", "num_key_value_heads",
                                               "intermediate_size", "vocab_size", "tie_word_embeddings", "max_position_embeddings"]},
       "parametry_razem": razem, "tabela_slownika": slownik, "tabela_slownika_wymiary": list(emb.shape),
       "tabela_wspolna_wejscie_wyjscie": wspolna, "bez_tabeli_slownika": razem - slownik,
       "udzial_tabeli_slownika_%": round(100 * slownik / razem, 2),
       "len_tokenizer": dlugosc, "pozycje_ponad_tokenizer": len(nadmiar), "z_nich_bez_tekstu": len(bez_tekstu),
       "przyklady_ponad_tokenizer": {i: tok.convert_ids_to_tokens(i) for i in nadmiar[:3] + nadmiar[-2:]}}
for k, v in res.items():
    if k != "meta":
        print(f"{k}: {v}")
zapisz_json("parametry.json", res)Cały wynik jako tekst (do skopiowania)
$ python parametry.py
Loading weights: 100%|██████████████████████████████████████████| 310/310 [00:02<00:00, 114.41it/s]
config: {'num_hidden_layers': 28, 'hidden_size': 1024, 'num_attention_heads': 16, 'num_key_value_heads': 8, 'intermediate_size': 3072, 'vocab_size': 151936, 'tie_word_embeddings': True, 'max_position_embeddings': 32768}
parametry_razem: 596049920
tabela_slownika: 155582464
tabela_slownika_wymiary: [151936, 1024]
tabela_wspolna_wejscie_wyjscie: True
bez_tabeli_slownika: 440467456
udzial_tabeli_slownika_%: 26.1
len_tokenizer: 151669
pozycje_ponad_tokenizer: 267
z_nich_bez_tekstu: 267
przyklady_ponad_tokenizer: {151669: None, 151670: None, 151671: None, 151934: None, 151935: None}
zapisano parametry.jsonWynik.
| Co | Wartość |
|---|---|
| Parametry razem | 596 049 920 |
| Tabela słownika (151 936 × 1024) | 155 582 464, czyli 26,1% |
| Bez tabeli słownika | 440 467 456 (zgodnie z kartą modelu: 0,44 mld) |
| Warstwy i długość wektora | 28 warstw, 1024 liczby |
| Tabela wspólna dla wejścia i wyjścia | tak (tie_word_embeddings) |
| Kawałków w tokenizerze | 151 669 |
Tabela ma 267 wierszy więcej niż słownik ma kawałków (od 151 669 do 151 935) i żaden z nich nie ma przypisanego tekstu. Stąd 151 936 ocen na wyjściu modelu przy 151 669 kawałkach słownika. Wspólna tabela znaczy, że te same współrzędne kartek służą na wejściu i do oceniania kandydatów na wyjściu.
6. Dwa słowniki, to samo zdanie
Co sprawdza. Jak to samo zdanie tną dwa tokenizery: o200k_base (z którego korzystam przy cięciu na kartki) i tokenizer Qwen3 (modelu, na którym liczę rozkłady).
python slowniki.pyPokaż kod: slowniki.py
"""Porównanie cięcia tego samego tekstu przez dwa tokenizery: o200k_base (tiktoken, scena 3) i Qwen3 (scena 6).
Uruchomienie: python slowniki.py   (tiktoken 0.14.0, transformers 5.19.0). Wynik: slowniki.json
"""
import tiktoken
from transformers import AutoTokenizer
from _wspolne import MODEL_BAZOWY, REWIZJA_BAZOWY, meta, zapisz_json

enc = tiktoken.get_encoding("o200k_base")
qwen = AutoTokenizer.from_pretrained(MODEL_BAZOWY, revision=REWIZJA_BAZOWY)
texts = ["Niebo jest", "Dlaczego niebo jest niebieskie?", "The sky is", "Why is the sky blue?"]
out = {"meta": meta(model=MODEL_BAZOWY, rewizja=REWIZJA_BAZOWY),
       "o200k_base": {"n_vocab": enc.n_vocab}, "qwen3": {"len_tokenizer": len(qwen)}, "texty": {}}
for t in texts:
    a = enc.encode(t); b = qwen(t)["input_ids"]
    out["texty"][t] = {
        "o200k_base": {"n": len(a), "tokeny": [enc.decode([i]) for i in a], "id": a},
        "qwen3": {"n": len(b), "tokeny": [qwen.decode([i]) for i in b], "id": b},
    }
    print(repr(t)); print("  o200k:", len(a), [enc.decode([i]) for i in a], a); print("  qwen3:", len(b), [qwen.decode([i]) for i in b], b)
zapisz_json("slowniki.json", out)Cały wynik jako tekst (do skopiowania)
$ python slowniki.py
Warning: You are sending unauthenticated requests to the HF Hub. Please set a HF_TOKEN to enable higher rate limits and faster downloads.
'Niebo jest'
  o200k: 3 ['Nie', 'bo', ' jest'] [52228, 1692, 12637]
  qwen3: 3 ['Nie', 'bo', ' jest'] [76383, 749, 13296]
'Dlaczego niebo jest niebieskie?'
  o200k: 9 ['Dl', 'aczego', ' nie', 'bo', ' jest', ' nie', 'bies', 'kie', '?'] [136923, 182265, 4725, 1692, 12637, 4725, 73826, 51201, 30]
  qwen3: 11 ['D', 'l', 'acz', 'ego', ' nie', 'bo', ' jest', ' nie', 'bies', 'kie', '?'] [35, 75, 41830, 13243, 11316, 749, 13296, 11316, 56673, 30322, 30]
'The sky is'
  o200k: 3 ['The', ' sky', ' is'] [976, 17307, 382]
  qwen3: 3 ['The', ' sky', ' is'] [785, 12884, 374]
'Why is the sky blue?'
  o200k: 6 ['Why', ' is', ' the', ' sky', ' blue', '?'] [13903, 382, 290, 17307, 9861, 30]
  qwen3: 6 ['Why', ' is', ' the', ' sky', ' blue', '?'] [10234, 374, 279, 12884, 6303, 30]
zapisano slowniki.jsonWynik. „Dlaczego niebo jest niebieskie?” to 9 tokenów w o200k_base i 11 w tokenizerze Qwen3 (D, l, acz, ego, nie, bo, jest, nie, bies, kie, ?). Numery też są inne: „bo” to 1692 i 749, „ nie” 4725 i 11316, „ jest” 12637 i 13296. Wspólny jest tylko znak zapytania (30). „Niebo jest” i „The sky is” tną się w obu słownikach tak samo, ale z innymi numerami (np. „Niebo jest”: 52228, 1692, 12637 i 76383, 749, 13296). Rozmiary słowników: 200 019 i 151 669.
7. Rozkład następnego tokenu i temperatura
Co sprawdza. Jak model Qwen3-0.6B-Base ocenia kandydatów na następny kawałek po „Niebo jest” i po „The sky is”, i jak ten rozkład zmienia temperatura (0,2, 1,0 i 1,5). Wyniki modelu liczone są w float32, a softmax w float64.
python pairs.pyPokaż kod: pairs.py
"""Rozkład następnego tokenu w Qwen3-0.6B-Base dla 5 par promptów PL/EN (scena 6) przy T = 1,0 / 0,2 / 1,5.

Wyniki modelu (logity) w float32, softmax w float64. Pierwsza para ("Niebo jest" / "The sky is") jest w filmie.
Uruchomienie: python pairs.py   (torch 2.14.1, transformers 5.19.0, CPU, float32). Wynik: dist2.json
"""
import torch, warnings
warnings.filterwarnings("ignore")
from transformers import AutoTokenizer, AutoModelForCausalLM
from _wspolne import MODEL_BAZOWY, REWIZJA_BAZOWY, meta, zapisz_json

name = MODEL_BAZOWY
tok = AutoTokenizer.from_pretrained(name, revision=REWIZJA_BAZOWY)
model = AutoModelForCausalLM.from_pretrained(name, revision=REWIZJA_BAZOWY, dtype=torch.float32).eval()
pairs = [
 ("Niebo jest", "The sky is"),
 ("Stolicą Francji jest", "The capital of France is"),
 ("Pies szczeka, a kot", "The dog barks and the cat"),
 ("Dwa plus dwa równa się", "Two plus two equals"),
 ("Woda zamarza w temperaturze zero stopni", "Water freezes at zero degrees"),
]
res = {"meta": meta(model=name, rewizja=REWIZJA_BAZOWY), "model": name, "layers": model.config.num_hidden_layers,
       "logits_dim": model.config.vocab_size, "len_tokenizer": len(tok), "pairs": []}
def run(prompt):
    ids = tok(prompt, return_tensors="pt")
    with torch.no_grad():
        lg = model(**ids).logits[0, -1].float()
    out = {"prompt": prompt, "tokens": [tok.decode([t]) for t in ids["input_ids"][0]], "T": {}}
    for T in [1.0, 0.2, 1.5]:
        p = torch.softmax(lg.double() / T, dim=-1)
        top = torch.topk(p, 8)
        out["T"][str(T)] = {"top": [(tok.decode([i]), round(v.item()*100, 2)) for v, i in zip(top.values, top.indices)],
                            "top8_sum": round(top.values.sum().item()*100, 2),
                            "n_over_1e-6": int((p > 1e-6).sum().item())}
    return out
for pl, en in pairs:
    a, b = run(pl), run(en)
    res["pairs"].append({"pl": a, "en": b})
    for r in (a, b):
        t = r["T"]["1.0"]
        print(f"{r['prompt']!r} {r['tokens']}\n   T=1: " + ", ".join(f"{x!r} {y}%" for x, y in t["top"]) + f" | top8={t['top8_sum']}% n>1e-6={t['n_over_1e-6']}")
zapisz_json("dist2.json", res)
print("layers", res["layers"], "logits_dim", res["logits_dim"], "len_tokenizer", res["len_tokenizer"])Cały wynik jako tekst (do skopiowania)
$ python pairs.py
Loading weights: 100%|██████████████████████████████████████████| 310/310 [00:00<00:00, 481.21it/s]
'Niebo jest' ['Nie', 'bo', ' jest']
   T=1: ' ' 9.0%, ' w' 7.22%, ' z' 3.91%, ' o' 2.85%, ' po' 1.9%, ' na' 1.72%, ' naj' 1.6%, ' p' 1.26% | top8=29.46% n>1e-6=7301
'The sky is' ['The', ' sky', ' is']
   T=1: ' blue' 20.96%, ' a' 10.67%, ' full' 5.73%, ' the' 4.71%, ' clear' 3.84%, ' filled' 1.99%, ' dark' 1.79%, ' so' 1.56% | top8=51.25% n>1e-6=5430
'Stolicą Francji jest' ['St', 'olic', 'ą', ' Franc', 'ji', ' jest']
   T=1: ' ' 3.16%, ' w' 2.11%, ' z' 2.0%, ' k' 1.84%, ' naj' 1.48%, ' now' 1.08%, ' nie' 0.87%, ' wie' 0.81% | top8=13.34% n>1e-6=13438
'The capital of France is' ['The', ' capital', ' of', ' France', ' is']
   T=1: ' Paris' 34.57%, ' ____' 10.98%, ' __' 7.2%, ' ______' 6.16%, ' _____' 3.97%, '____' 3.41%, ' called' 2.16%, ' located' 1.4% | top8=69.84% n>1e-6=4338
'Pies szczeka, a kot' ['P', 'ies', ' szcz', 'eka', ',', ' a', ' kot']
   T=1: 'ek' 20.06%, 'ka' 14.38%, 'y' 9.07%, ',' 2.57%, 'ki' 2.54%, ' jest' 2.15%, ' w' 1.51%, 'em' 1.15% | top8=53.42% n>1e-6=7146
'The dog barks and the cat' ['The', ' dog', ' b', 'arks', ' and', ' the', ' cat']
   T=1: ' me' 44.09%, ' y' 24.6%, ' b' 3.39%, ' pur' 3.12%, ' sleeps' 2.3%, ' ch' 1.95%, ' chir' 1.61%, ' sits' 1.09% | top8=82.16% n>1e-6=2309
'Dwa plus dwa równa się' ['D', 'wa', ' plus', ' d', 'wa', ' równ', 'a', ' się']
   T=1: ' cz' 21.5%, ' ' 12.07%, ' tr' 9.3%, '...' 7.7%, ' pi' 3.61%, ':' 3.54%, ' ...' 2.95%, ' co' 2.72% | top8=63.39% n>1e-6=2469
'Two plus two equals' ['Two', ' plus', ' two', ' equals']
   T=1: ' four' 25.5%, ' what' 10.47%, ' two' 9.48%, ' three' 4.42%, ' ' 4.16%, ' zero' 3.68%, ' five' 3.49%, ' to' 2.81% | top8=64.01% n>1e-6=2579
'Woda zamarza w temperaturze zero stopni' ['W', 'oda', ' z', 'amar', 'za', ' w', ' temper', 'atur', 'ze', ' zero', ' stop', 'ni']
   T=1: ' C' 62.25%, ' c' 21.57%, ' Celsius' 3.51%, ' Cel' 2.14%, ' cel' 1.78%, '.' 1.03%, ',' 0.99%, ' cent' 0.9% | top8=94.16% n>1e-6=1276
'Water freezes at zero degrees' ['Water', ' freezes', ' at', ' zero', ' degrees']
   T=1: ' Celsius' 88.11%, ' Fahrenheit' 2.15%, ' on' 1.7%, ' cent' 1.58%, ' and' 1.24%, '.' 0.85%, ' in' 0.75%, ',' 0.61% | top8=96.99% n>1e-6=512
zapisano dist2.json
layers 28 logits_dim 151936 len_tokenizer 151669Wynik. Przy temperaturze 1,0:
| Zdanie | Najwyższy słupek | Osiem pierwszych razem | Kandydatów z szansą większą niż 1 na milion |
|---|---|---|---|
| The sky is | blue 20,96% | 51,25% | 5 430 |
| Niebo jest | sama spacja 9,00% | 29,46% | 7 301 |
Osiem pierwszych dla „The sky is”: blue 20,96, a 10,67, full 5,73, the 4,71, clear 3,84, filled 1,99, dark 1,79, so 1,56 (%). Dla „Niebo jest”: spacja 9,00, w 7,22, z 3,91, o 2,85, po 1,90, na 1,72, naj 1,60, p 1,26 (%). Tak samo pomiar wygląda przy trzech temperaturach:
| Zdanie | T = 0,2 | T = 1,0 | T = 1,5 |
|---|---|---|---|
| The sky is, szansa „blue” | 96,47% | 20,96% | 4,80% |
| The sky is, kandydatów powyżej 1 na milion | 10 | 5 430 | 21 622 |
| Niebo jest, szansa spacji | 73,96% | 9,00% | 1,99% |
| Niebo jest, kandydatów powyżej 1 na milion | 23 | 7 301 | 33 595 |
Ten sam model, to samo pytanie, a po polsku jest wyraźnie mniej pewny. Pomiar pokazuje różnicę, nie jej przyczynę, i dotyczy jednego zdania na jednym małym modelu. Plik dist2.json zawiera jeszcze trzy pary zdań i wzorce są różne: „The capital of France is” ma lidera „Paris” (34,57%), a „Stolicą Francji jest” nie ma wyraźnego (najwyższa jest spacja, 3,16%); „Water freezes at zero degrees” i „Woda zamarza w temperaturze zero stopni” mają wyraźnego lidera w obu językach (88,11% i 62,25%). Dlatego nie uogólniam na „polski zawsze gorzej”.
8. Losowanie, ziarno i zero w softmaksie
Co sprawdza. Dwie rzeczy naraz. Po pierwsze: czy softmax kiedykolwiek daje któremuś z 151 936 kandydatów dokładnie zero (sprawdzam w float32 i float64). Po drugie: prawdziwe losowania z modelu, z dziesięcioma ziarnami, trzema temperaturami (1,0, 1,5 i 2,0) i dwoma zdaniami, po 24 nowe tokeny. Losowanie jest czyste: tylko temperatura, bez Top-K i Top-P. Wyłączam je jawnie (top_k=0, top_p=1.0), bo biblioteka Hugging Face domyślnie przyjmuje top_k = 50.
python losowanie.pyPokaż kod: losowanie.py
"""Prawdziwe losowanie z Qwen3-0.6B-Base dla sceny 7 (rozsypujący się tekst przy wysokiej temperaturze)
oraz sprawdzenie, czy softmax daje któremukolwiek tokenowi dokładnie zero.

Czyste próbkowanie z rozkładu softmax(z / T): bez Top-K i bez Top-P (wyłączone jawnie, bo domyślne
ustawienia generation_config mogłyby je włączyć). Seedy 1..N, wynik w losowanie.json.
Uruchomienie: python losowanie.py   (torch 2.14.1, transformers 5.19.0, CPU, float32)
"""
import json, warnings
import torch
warnings.filterwarnings("ignore")
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
from _wspolne import MODEL_BAZOWY, REWIZJA_BAZOWY, meta, zapisz_json

NAME = MODEL_BAZOWY
PROMPTS = ["Niebo jest", "The sky is"]
TEMPS = [1.0, 1.5, 2.0]
SEEDS = range(1, 11)
NEW = 24

tok = AutoTokenizer.from_pretrained(NAME, revision=REWIZJA_BAZOWY)
model = AutoModelForCausalLM.from_pretrained(NAME, revision=REWIZJA_BAZOWY, dtype=torch.float32).eval()
res = {"meta": meta(model=NAME, rewizja=REWIZJA_BAZOWY), "model": NAME, "torch": torch.__version__, "new_tokens": NEW,
       "sampling": "temperature only, top_k=0, top_p=1.0", "samples": [], "zero_check": {}}

for prompt in PROMPTS:
    ids = tok(prompt, return_tensors="pt")
    # Czy któryś z 151 936 wyników ma prawdopodobieństwo dokładnie 0?
    with torch.no_grad():
        lg = model(**ids).logits[0, -1]
    for T in (1.0, 1.5):
        p32 = torch.softmax(lg.float() / T, dim=-1)
        p64 = torch.softmax(lg.double() / T, dim=-1)
        res["zero_check"][f"{prompt}|T={T}"] = {
            "n": int(p64.numel()),
            "zeros_float32": int((p32 == 0).sum()),
            "zeros_float64": int((p64 == 0).sum()),
            "min_float64": float(p64.min()),
        }
    for T in TEMPS:
        for seed in SEEDS:
            set_seed(seed)
            out = model.generate(**ids, do_sample=True, temperature=T, top_k=0, top_p=1.0,
                                 max_new_tokens=NEW, pad_token_id=tok.eos_token_id)
            text = tok.decode(out[0], skip_special_tokens=True)
            res["samples"].append({"prompt": prompt, "T": T, "seed": seed, "text": text})
            print(f"[{prompt!r} T={T} seed={seed}] {text!r}")

zapisz_json("losowanie.json", res)
print(json.dumps(res["zero_check"], indent=1))Cały wynik jako tekst (do skopiowania)
$ python losowanie.py
Loading weights: 100%|██████████████████████████████████████████| 310/310 [00:00<00:00, 572.95it/s]
['Niebo jest' T=1.0 seed=1] 'Niebo jest nad tym bąbkiem, Skwo fiętrz nadbiegają? Wszyscy ucie'
['Niebo jest' T=1.0 seed=2] 'Niebo jest dobrze zdobytym miejscem na zjawiska w przestrzeni osiemiagonkowej ram'
['Niebo jest' T=1.0 seed=3] 'Niebo jest miłym myślczącym, a dziadłem stoi w imię dzwonecznika.\nGłow'
['Niebo jest' T=1.0 seed=4] 'Niebo jest zastępniczą dla wielu krajów Afryki.\n\nOdpowiedź:\n\nA\nSiema'
['Niebo jest' T=1.0 seed=5] 'Niebo jest cara między geologem Johnem a artizanom Richardem. 两人关系一度复杂被迫分离 两个'
['Niebo jest' T=1.0 seed=6] 'Niebo jest 40 km od góry natomiast Lenka jest 20 kręgosłupów. Sk'
['Niebo jest' T=1.0 seed=7] 'Niebo jest pełen nunajwściekłości. Satyrobiczy miniatuny pokrywają ko'
['Niebo jest' T=1.0 seed=8] 'Niebo jestim kru criminalnym, który rozmawiał z? Opuszczało w jaki sposób koncert'
['Niebo jest' T=1.0 seed=9] 'Niebo jest wykonywany jako wyraz oznaczający jedymiazowy czas (od systemu czasu UTC'
['Niebo jest' T=1.0 seed=10] 'Niebo jest świetnie radzy, który uciskuje pęd po każdym drogi wykrywanej na sk'
['Niebo jest' T=1.5 seed=1] 'Niebo jest nad tym biker奇状みたいなหุ fi 필 관의.performe itDMETHOD皋 design score efficiently prioritize detail一点点'
['Niebo jest' T=1.5 seed=2] 'Niebo jest dobrze stabilną, ładą MSR GP Polynomial form yüz ilaç forever Premier Radﺍ(X doğannya waar har say כל'
['Niebo jest' T=1.5 seed=3] 'Niebo jest miere kısm naprawdę spialla gwury[i][j_BANK_TRANSACTION_UNIVERS_DAY}.decrypt(mbothbangrans picoul'
['Niebo jest' T=1.5 seed=4] 'Niebo jest gastrelkázstra.To ure Approved jazırlarıdoftq Fôkrä NETRelatenuxcon Thành'
['Niebo jest' T=1.5 seed=5] 'Niebo jest cara diy days_Closeὒ niveau mijn Point..." YuanNie2 Should fanству_grad нужно играть Analogicon зависимости.stereotype dla degrees'
['Niebo jest' T=1.5 seed=6] 'Niebo jest brzmiwe Her presidency Sinclair had perfected though car depends Signal predicts Star is only former Column genera thrown Ron does much'
['Niebo jest' T=1.5 seed=7] 'Niebo jest pełen nun ng duhoia roomnameathanrellaney Hollow thatsっき min atun cubnum flametragoot'
['Niebo jest' T=1.5 seed=8] 'Niebo jestim Dyslay criminal giám thị với kiến thứccn shaft năm얼onden Từbdiscount nhậpBootstrap Ship Storage dump System thêm'
['Niebo jest' T=1.5 seed=9] [tekst ukryty w nagraniu przez filtr treści]
['Niebo jest' T=1.5 seed=10] 'Niebo jest świetthouse radially dikretnieżnym ekrzem fildrazy wykrywaniem meble.'
['Niebo jest' T=2.0 seed=1] 'Niebo jest nad tym.TR Pierre奇状重回หvoir fi 필 관 پ.performonder GardnerDMETHOD皋 design שא efficiently prioritize㉡格林'
['Niebo jest' T=2.0 seed=2] 'Niebo jest dobr弨<\\/ỏi>[ละ弋序列数对 Toni וכן forever 数 batchﺍ.call doğ의 buz har bang כל'
['Niebo jest' T=2.0 seed=3] 'Niebo jest kepripelow akka spialla gwcriptsqliast null klientli femme ata decadbaz fib reach-wide-flex Qin picoul'
['Niebo jest' T=2.0 seed=4] 'Niebo jest gastrel la magstraראו HDC Approved ReclinersHairdo Washing Utilities Fennon Fasc NETEV Travel Kilcon Thành'
['Niebo jest' T=2.0 seed=5] 'Niebo jest cara diy days_Closeὒ niveaueldo Point giorni臘ließlich2 elegance Weldству_grad牵挤לאحضور зависимости.stereotype dla degrees'
['Niebo jest' T=2.0 seed=6] 'Niebo jest state aucym bed Her presidency Sinclair had perfectedMED ANSWER Signal loweredrollo(predict.prevfed Column genera thrown Roniness\tversion'
['Niebo jest' T=2.0 seed=7] [tekst ukryty w nagraniu przez filtr treści]
['Niebo jest' T=2.0 seed=8] 'Niebo jest tourenหลัก少儿 giám层级县你们的地方 馆얼ニュ出会い冲突国会受usize本质上やら揖丘怜'
['Niebo jest' T=2.0 seed=9] 'Niebo jest wyegas使用的Development Document好好勤劳想知道真假*d的对象束糊debug充当区块esc其实抛_Reference across qualified jsx '
['Niebo jest' T=2.0 seed=10] "Niebo jest świetthouse radisson dik/blue immoral waste לשם scorQui'a byte të adulbidden ter émes evidenced me nodeدى"
['The sky is' T=1.0 seed=1] 'The sky is clear of clouds, and the temperature is expected to rise to 22°C at noon today. I prioritize doing activity'
['The sky is' T=1.0 seed=2] 'The sky is azure blue,the water is clean and the grass is green____ forever\nAnswer:\nnever previously\n\nWhich of the following'
['The sky is' T=1.0 seed=3] 'The sky is blue.\n- Does the sky reflect white clouds? No, because white clouds are typically associated with grey or black, not'
['The sky is' T=1.0 seed=4] 'The sky is blue. If the sky is twice as far from the Earth than the beach, and the distance from the Earth to the'
['The sky is' T=1.0 seed=5] 'The sky is currently 13,500 feet high and the sun is shining. Jack is currently 30 feet degrees'
['The sky is' T=1.0 seed=6] "The sky is littered with dust particles, creating a world of swirling and tingling light. It's like nothing seen before. Bene"
['The sky is' T=1.0 seed=7] 'The sky is clear. All our senses are tuned-in. The water is cooler than expected. The sun is bright. With no wind'
['The sky is' T=1.0 seed=8] [tekst ukryty w nagraniu przez filtr treści]
['The sky is' T=1.0 seed=9] 'The sky is filled with iridescent waves stretching down to the square metre. Laplaces pendulum (C11) moves apart'
['The sky is' T=1.0 seed=10] 'The sky is now not just a waiting place, but also the e-book terminal.\nNetscape Mount Baker 15 node web'
['The sky is' T=1.5 seed=1] 'The sky is mostly made up of molecules \n-the allowed structures fi m empty fakes sont it beyond corporation design score efficiently prioritize pitfalls activity'
['The sky is' T=1.5 seed=2] 'The sky is azure–ionic reacts bc subtotal L_q change rapid rate procedure forever secured batchﺍ.call doğannya buz har say כל'
['The sky is' T=1.5 seed=3] 'The sky is kepripotic using spialla gocripts[i][j_BANK_TRANSACTION_UNIVERS_DAY}. Merch reach-wide-flex Qin picoul'
['The sky is' T=1.5 seed=4] 'The sky is greywald the Long Moon She flies bewey When King Afdoft my Fennon is hungry, Travel Kilconary'
['The sky is' T=1.5 seed=5] 'The sky is thick porous days Mayὒ蟲Νín giorni臘ließlich2ǐ Weldству_gradINGGERלאحضورუ.stereotype dla degrees'
['The sky is' T=1.5 seed=6] 'The sky is beyond criticizing.Beyond Her presidency lays had perfectedMED ANSWER\nIM CONTRAST SIMPLE STATE Column genera thrown Roniness的记忆'
['The sky is' T=1.5 seed=7] 'The sky is sixteen thousand nun," dunder?\n\ndunameathanrellivedilessinsproppedmadeunloudnumcolumnshrßoot'
['The sky is' T=1.5 seed=8] 'The sky is blue. Tuesdreds retence sacks, incredible shaft pours sconden interesting+discount noticesusize medicends aromatic personality engaging'
['The sky is' T=1.5 seed=9] 'The sky is previewing battle\xa0\nDragon walker thaw Contract promotion*d square ill Armor Lap logo Large Sale hole an french across through invitation Ning'
['The sky is' T=1.5 seed=10] 'The sky is now,... over Britain.In Slovakia,even Czech remained scorched.seventh woman adul thi received her visa🛬 wed node.'
['The sky is' T=2.0 seed=1] 'The sky is miles of how its tire-spinney allowed walnut fiorra empty ships.performonder itDMETHOD皋 design score efficiently prioritize pitfalls格林'
['The sky is' T=2.0 seed=2] 'The sky is azure–ion recorder reacts bc subtotal L_ques,, Toni compens forever secured batchﺍ.call doğ의 buz Accessed requ כל'
['The sky is' T=2.0 seed=3] 'The sky is kepripotic using spi FHA Controlled Prescription Upgrade Permit null_BANK_TRANSACTION_UNIVERS_DAY}. Merch𬕂 Datesstroy Qin₦住'
['The sky is' T=2.0 seed=4] "The sky is surrounded.chat.gif\\r⌈ראו HDC Approved Re CCTV PlansHairdo Torrent channel*'┃诱惑 NETRel Source Kilcon Thành"
['The sky is' T=2.0 seed=5] 'The sky is broadcasting diy daysswireὒ蟲ǟ𝘯 giorni臘痦2ǐ phạtству_grad能够挤我们icon被迫.stereotype dla degrees'
['The sky is' T=2.0 seed=6] "The sky is beyond criticizing.B'D Her presidency lays had perfectedMED car depends.There predictsrollo(predict.prevfed Column genera thrown Roniness的记忆"
['The sky is' T=2.0 seed=7] 'The sky is sixteen thousand nunencv duorean battleground roomname(leftrellivedilessinsっきหญิง请你赞美棠留蕹媁独角'
['The sky is' T=2.0 seed=8] [tekst ukryty w nagraniu przez filtr treści]
['The sky is' T=2.0 seed=9] 'The sky is preview Tumblr battle\xa0\nDragon好好包袱 Contract promotion*d square束糊debug充当区块esc其实抛_Reference acrossloading(dialog Ning'
['The sky is' T=2.0 seed=10] 'The sky is inverted,...¯ radially dik [% immoral cad愎 scorQui %.Why prompting adulM\tPortPear油田Adult wed nodeدى'
zapisano losowanie.json
{
 "Niebo jest|T=1.0": {
  "n": 151936,
  "zeros_float32": 0,
  "zeros_float64": 0,
  "min_float64": 3.2088603051862424e-15
 },
 "Niebo jest|T=1.5": {
  "n": 151936,
  "zeros_float32": 0,
  "zeros_float64": 0,
  "min_float64": 2.1515696391275103e-11
 },
 "The sky is|T=1.0": {
  "n": 151936,
  "zeros_float32": 0,
  "zeros_float64": 0,
  "min_float64": 3.6429100938552376e-16
 },
 "The sky is|T=1.5": {
  "n": 151936,
  "zeros_float32": 0,
  "zeros_float64": 0,
  "min_float64": 6.946079891679321e-12
 }
}Wynik. Zer w softmaksie nie ma: 0 z 151 936 wartości dla obu zdań i obu temperatur (1,0 i 1,5), w obu precyzjach. Najmniejsze prawdopodobieństwa to u mnie 3,2e-15 po polsku i 3,6e-16 po angielsku przy temperaturze 1,0 oraz 2,2e-11 i 6,9e-12 przy 1,5. Zgadza się to ze wzorem (exp(z/T) jest zawsze większe od zera). Twierdzenie dotyczy tych dwóch rozkładów, nie wszystkich możliwych: przy bardzo ujemnych wynikach w skończonej precyzji wartość mogłaby się zaokrąglić do zera.
Dwa losowania z filmu, ten sam model, początek i ziarno 1, zmieniona tylko temperatura:
| Temperatura | Tekst |
|---|---|
| 1,0 | Niebo jest nad tym bąbkiem, Skwo fiętrz nadbiegają? Wszyscy ucie |
| 1,5 | Niebo jest nad tym biker奇状みたいなหุ fi 필 관의.performe itDMETHOD皋 design score efficiently prioritize detail一点点 |
Ziarno 1 to pierwsze z dziesięciu, nie wybierałem najlepszego; skrypt zapisze wszystkie sześćdziesiąt losowań w losowanie.json, a SEEDS i PROMPTS w skrypcie możesz zmienić, żeby wylosować własne. Przy T = 1,5 tekst w większości losowań szybko traci spójność (po polsku i po angielsku). Przy T = 1,0 angielski jest zwykle składny, a polski tego małego modelu bywa niespójny już przy T = 1,0. To zachowanie małego modelu bazowego bez Top-K i Top-P, nie reguła dla ChatGPT.
9. Kiedy wypada kartka końca
Co sprawdza. Jaką szansę ma specjalna kartka końca odpowiedzi przed każdą kolejną kartką odpowiedzi. Użyłem czatowej wersji modelu (Qwen3-0.6B, ta sama rodzina i ten sam słownik), tryb myślenia wyłączony, odpowiedź zachłanna, czyli zawsze najwyższy słupek, więc za każdym razem taka sama. Potem jeden przebieg po całej odpowiedzi odczytuje szansę kartki <|im_end|> (numer 151645).
python koniec.pyPokaż kod: koniec.py
"""Kiedy rośnie szansa kartki końca? (ujęcia 47 i 47b)

Czatowy Qwen3-0.6B (ta sama rodzina i ten sam słownik co Qwen3-0.6B-Base) odpowiada na pytanie z filmu.
Odpowiedź jest zachłanna (zawsze najwyższy słupek), więc za każdym razem ta sama. Potem jeden przebieg
po całej odpowiedzi: przed każdą kolejną kartką odczytujemy szansę kartki końca <|im_end|> (151645).
Tryb myślenia wyłączony (enable_thinking=False), żeby odpowiedź nie zaczynała się od <think>.
Uruchomienie: python koniec.py   (torch 2.14.1, transformers 5.19.0, CPU, float32). Wynik: koniec.json
"""
import torch, warnings
warnings.filterwarnings("ignore")
from transformers import AutoTokenizer, AutoModelForCausalLM
from _wspolne import MODEL_CZAT, REWIZJA_CZAT, meta, zapisz_json

PYTANIA = ["Dlaczego niebo jest niebieskie? Odpowiedz jednym zdaniem.",  # pytanie z filmu
           "Jaka jest stolica Francji? Odpowiedz jednym zdaniem."]       # zapas: krótka, poprawna odpowiedź
MAKS = 80

tok = AutoTokenizer.from_pretrained(MODEL_CZAT, revision=REWIZJA_CZAT)
model = AutoModelForCausalLM.from_pretrained(MODEL_CZAT, revision=REWIZJA_CZAT, dtype=torch.float32).eval()
KONIEC = tok.convert_tokens_to_ids("<|im_end|>")
KONIEC_TEKSTU = tok.convert_tokens_to_ids("<|endoftext|>")


def odpowiedz(pytanie):
    prompt = tok.apply_chat_template([{"role": "user", "content": pytanie}], tokenize=False,
                                     add_generation_prompt=True, enable_thinking=False)
    ids = tok(prompt, return_tensors="pt")["input_ids"]
    plen = ids.shape[1]
    print(f"# pytanie: {pytanie}")
    with torch.no_grad():
        pelne = model.generate(ids, do_sample=False, max_new_tokens=MAKS, pad_token_id=KONIEC_TEKSTU)[0]
        p = torch.softmax(model(pelne.unsqueeze(0)).logits[0].double(), dim=-1)
    kroki = []
    for j in range(plen, len(pelne)):  # kartka na pozycji j; rozkład przed nią to wiersz j-1
        t = int(pelne[j])
        kroki.append({"kartka": tok.decode([t]), "id": t,
                      "p_wybranej_%": round(100 * p[j - 1, t].item(), 4),
                      "p_koniec_%": round(100 * p[j - 1, KONIEC].item(), 6),
                      "p_koniec_tekstu_%": round(100 * p[j - 1, KONIEC_TEKSTU].item(), 6)})
        print(f"{tok.decode([t])!r:>14}  p(koniec) przed nią = {kroki[-1]['p_koniec_%']:.6f}%")
    tekst = tok.decode(pelne[plen:], skip_special_tokens=True)
    print(f"# odpowiedź modelu: {tekst}")
    return {"pytanie": pytanie, "prompt": prompt, "odpowiedz": tekst,
            "zakonczona_kartka_konca": int(pelne[-1]) == KONIEC, "kroki": kroki}


res = {"meta": meta(model=MODEL_CZAT, rewizja=REWIZJA_CZAT),
       "kartka_konca": {"tekst": "<|im_end|>", "id": KONIEC}, "kartka_konca_tekstu": {"tekst": "<|endoftext|>", "id": KONIEC_TEKSTU},
       "eos_token_id_generation_config": model.generation_config.eos_token_id,
       "odpowiedzi": [odpowiedz(q) for q in PYTANIA]}
zapisz_json("koniec.json", res)Cały wynik jako tekst (do skopiowania)
$ python koniec.py
Warning: You are sending unauthenticated requests to the HF Hub. Please set a HF_TOKEN to enable higher rate limits and faster downloads.
Loading weights: 100%|██████████████████████████████████████████| 311/311 [00:02<00:00, 140.97it/s]
# pytanie: Dlaczego niebo jest niebieskie? Odpowiedz jednym zdaniem.
'Nie' p(koniec) przed nią = 0.000000%
'bo' p(koniec) przed nią = 0.000000%
' jest' p(koniec) przed nią = 0.000000%
' nie' p(koniec) przed nią = 0.000000%
'bies' p(koniec) przed nią = 0.000000%
'kie' p(koniec) przed nią = 0.000000%
' ponieważ' p(koniec) przed nią = 0.000001%
' świat' p(koniec) przed nią = 0.000001%
'ło' p(koniec) przed nią = 0.000000%
' z' p(koniec) przed nią = 0.000001%
'iem' p(koniec) przed nią = 0.000004%
'sk' p(koniec) przed nią = 0.000000%
'ie' p(koniec) przed nią = 0.000000%
',' p(koniec) przed nią = 0.000002%
' które' p(koniec) przed nią = 0.000000%
' w' p(koniec) przed nią = 0.000002%
'ch' p(koniec) przed nią = 0.000000%
'odzi' p(koniec) przed nią = 0.000000%
' do' p(koniec) przed nią = 0.000000%
' nie' p(koniec) przed nią = 0.000000%
'ba' p(koniec) przed nią = 0.000000%
',' p(koniec) przed nią = 0.000000%
' ma' p(koniec) przed nią = 0.000002%
' bardzo' p(koniec) przed nią = 0.000001%
' wys' p(koniec) przed nią = 0.000001%
'oki' p(koniec) przed nią = 0.000000%
' stop' p(koniec) przed nią = 0.000001%
'ień' p(koniec) przed nią = 0.000000%
' z' p(koniec) przed nią = 0.000001%
'bro' p(koniec) przed nią = 0.000001%
'jen' p(koniec) przed nią = 0.000000%
'ia' p(koniec) przed nią = 0.000000%
',' p(koniec) przed nią = 0.000004%
' a' p(koniec) przed nią = 0.000009%
' więc' p(koniec) przed nią = 0.000001%
' nie' p(koniec) przed nią = 0.000006%
         ' ma'  p(koniec) przed nią = 0.000002%
          ' z'  p(koniec) przed nią = 0.000003%
          'as'  p(koniec) przed nią = 0.000003%
           'ł'  p(koniec) przed nią = 0.000000%
          'on'  p(koniec) przed nią = 0.000000%
          ' w'  p(koniec) przed nią = 0.000033%
       ' jego'  p(koniec) przed nią = 0.000013%
      ' wnętr'  p(koniec) przed nią = 0.000004%
          'zu'  p(koniec) przed nią = 0.000000%
           '.'  p(koniec) przed nią = 0.008496%
  '<|im_end|>'  p(koniec) przed nią = 90.266572%
# odpowiedź modelu: Niebo jest niebieskie ponieważ światło ziemskie, które wchodzi do nieba, ma bardzo wysoki stopień zbrojenia, a więc nie ma zasłon w jego wnętrzu.
# pytanie: Jaka jest stolica Francji? Odpowiedz jednym zdaniem.
          'St'  p(koniec) przed nią = 0.000000%
          'ol'  p(koniec) przed nią = 0.000000%
         'ica'  p(koniec) przed nią = 0.000000%
      ' Franc'  p(koniec) przed nią = 0.000000%
          'ji'  p(koniec) przed nią = 0.000000%
         ' to'  p(koniec) przed nią = 0.000000%
         ' **'  p(koniec) przed nią = 0.000000%
         'Par'  p(koniec) przed nią = 0.000000%
           'l'  p(koniec) przed nią = 0.000000%
          'az'  p(koniec) przed nią = 0.000000%
          'ja'  p(koniec) przed nią = 0.000000%
          '**'  p(koniec) przed nią = 0.000016%
           '.'  p(koniec) przed nią = 0.040517%
  '<|im_end|>'  p(koniec) przed nią = 99.997226%
# odpowiedź modelu: Stolica Francji to **Parlazja**.
zapisano koniec.jsonWynik. Na pytanie z filmu („Dlaczego niebo jest niebieskie? Odpowiedz jednym zdaniem.”) model odpowiada w 47 kartkach, razem z kartką końca. W środku odpowiedzi szansa kartki końca wynosi najwyżej 0,000033%, a zaraz po kropce, która zamyka odpowiedź, 90,27%. Sama odpowiedź („Niebo jest niebieskie ponieważ światło ziemskie, które wchodzi do nieba, ma bardzo wysoki stopień zbrojenia…”) jest merytorycznie błędna: kartka końca pilnuje formy zdania, a nie prawdy. Zapasowe pytanie o stolicę Francji dało „Stolica Francji to Parlazja.” (też błędnie), a szansa kartki końca po kropce wyniosła 99,997%. Generowanie zatrzymuje się na kartce końca albo na limicie długości (max_new_tokens).
10. Czy Twoje wyniki zgadzają się z moimi
Po uruchomieniu skryptów porównaj swoje pliki z moimi (leżą w wzorcowe-2026-10-09/):
python sprawdz.pyPokaż kod: sprawdz.py
"""Czy Twój przebieg pomiarów zgadza się z naszym? Porównuje świeże wyniki z wzorcowe-2026-10-09/.

Zasady porównania:
- numery tokenów i liczby tokenów: muszą być identyczne;
- procenty (zaokrąglone do 2 miejsc): różnica najwyżej 0,01;
- liczba kandydatów z szansą > 1e-6: różnica najwyżej 1;
- zera w softmaksie: identyczne, najmniejsze p: względna różnica najwyżej 1e-6;
- teksty losowań: przy tych samych wersjach bibliotek na CPU w float32 powinny być identyczne,
  ale mogą się różnić na innym procesorze lub systemie. Różnice są wtedy wypisane jako ZALEŻNE OD PLATFORMY,
  a błąd zgłaszamy tylko z opcją --scisle.
- wzorce losowań (losowanie.json, probki-lab.json) mogą mieć zamiast tekstów ich skróty SHA-256 (tak jest w paczce do
  pobrania, żeby nie publikować surowych losowań małego modelu); wtedy porównujemy skróty Twoich tekstów.
tok.json nie ma pliku wzorcowego, więc jego liczby porównujemy z wartościami podanymi w filmie.
Uruchomienie: python sprawdz.py [--scisle] [--wzorcowe KATALOG]   Kod wyjścia 0 = zgodność.
"""
import argparse, hashlib, json
from pathlib import Path
from _wspolne import KATALOG, wczytaj_json

ap = argparse.ArgumentParser()
ap.add_argument("--scisle", action="store_true", help="różne teksty losowań też są błędem")
ap.add_argument("--wzorcowe", default=str(KATALOG / "wzorcowe-2026-10-09"))
args = ap.parse_args()
W = Path(args.wzorcowe)
STRONA = KATALOG / "../../strona/src/data"
bledy, platforma = [], []


def blad(msg):
    bledy.append(msg); print("BŁĄD:", msg)


def sha(tekst):
    return hashlib.sha256(tekst.encode("utf-8")).hexdigest()


def tekst_zgodny(moj, wzor):
    """Wzorzec ma albo pełny tekst ("text"), albo jego skrót ("text_sha256")."""
    return moj == wzor["text"] if "text" in wzor else sha(moj) == wzor["text_sha256"]


def probka_zgodna(moja, wzor):
    """Próbka z probki-lab.json: pełna ({"t","p","r"}) albo skrót ({"sha256"}) jej postaci JSON."""
    if "sha256" in wzor and "t" not in wzor:
        return sha(json.dumps(moja, sort_keys=True, ensure_ascii=False)) == wzor["sha256"]
    return moja == wzor


def rowne(a, b, gdzie):
    if a != b:
        blad(f"{gdzie}: {a!r} != {b!r}")


def blisko(a, b, tol, gdzie):
    if abs(a - b) > tol:
        blad(f"{gdzie}: {a} vs {b} (tolerancja {tol})")


# Tokenizery
s, w = wczytaj_json("spacja.json"), wczytaj_json(W / "spacja.json")
for t in w["teksty"]:
    rowne(s["teksty"][t]["id"], w["teksty"][t]["id"], f"spacja.json {t!r}")
s, w = wczytaj_json("slowniki.json"), wczytaj_json(W / "slowniki.json")
for t in w["texty"]:
    for k in ("o200k_base", "qwen3"):
        rowne(s["texty"][t][k]["id"], w["texty"][t][k]["id"], f"slowniki.json {t!r} {k}")

# Liczby z filmu (scena 3, ujęcia 12, 18, 19)
t = wczytaj_json("tok.json")["kodowania"]
rowne((t["o200k_base"]["suma_pl"], t["o200k_base"]["suma_en"]), (72, 49), "tok.json o200k_base sumy")
rowne((t["cl100k_base"]["suma_pl"], t["cl100k_base"]["suma_en"]), (84, 49), "tok.json cl100k_base sumy")
rowne(t["o200k_base"]["pary"][0]["pl"]["id"], [136923, 182265, 4725, 1692, 12637, 4725, 73826, 51201, 30], "tok.json zdanie 1")
rowne(t["o200k_base"]["slowa"]["truskawka"]["id"], [371, 26604, 1134, 1854], "tok.json truskawka")
rowne(t["o200k_base"]["slowa"]["kot"]["id"], [74443], "tok.json kot")

# Rozkłady (scena 6)
s, w = wczytaj_json("dist2.json"), wczytaj_json(W / "dist2.json")
for i, (ps, pw) in enumerate(zip(s["pairs"], w["pairs"])):
    for lang in ("pl", "en"):
        for T, tw in pw[lang]["T"].items():
            ts, gdzie = ps[lang]["T"][T], f"dist2.json para {i} {lang} T={T}"
            rowne([x[0] for x in ts["top"]], [x[0] for x in tw["top"]], gdzie + " kandydaci")
            for (_, a), (_, b) in zip(ts["top"], tw["top"]):
                blisko(a, b, 0.01, gdzie + " %")
            blisko(ts["top8_sum"], tw["top8_sum"], 0.01, gdzie + " top8")
            blisko(ts["n_over_1e-6"], tw["n_over_1e-6"], 1, gdzie + " n>1e-6")

# Zera w softmaksie i losowania (scena 7)
s, w = wczytaj_json("losowanie.json"), wczytaj_json(W / "losowanie.json")
for k, zw in w["zero_check"].items():
    zs = s["zero_check"][k]
    rowne((zs["zeros_float32"], zs["zeros_float64"]), (zw["zeros_float32"], zw["zeros_float64"]), f"losowanie.json {k} zera")
    blisko(zs["min_float64"] / zw["min_float64"], 1.0, 1e-6, f"losowanie.json {k} min p")
inne = sum(not tekst_zgodny(a["text"], b) for a, b in zip(s["samples"], w["samples"]))
if inne:
    platforma.append(f"losowanie.json: {inne} z {len(w['samples'])} tekstów inne")

s, w = wczytaj_json("probki-lab.json"), wczytaj_json(W / "probki-lab.json")
inne = sum(not probka_zgodna(a, b) for k in w["samples"] for a, b in zip(s["samples"][k], w["samples"][k]))
if inne:
    platforma.append(f"probki-lab.json: {inne} z {sum(len(v) for v in w['samples'].values())} próbek inne")

# Pliki na stronę: w repozytorium leżą w strona/src/data, w paczce obok skryptów (opcja --wyjscie)
for nazwa in ("rozklad", "probki"):
    plik = next((p for p in (STRONA / f"{nazwa}.json", KATALOG / f"{nazwa}.json") if p.is_file()), None)
    if plik is None:
        print(f"pominięto {nazwa}.json (brak pliku)")
        continue
    wzorzec = W / f"strona-{nazwa}.json"
    if not wzorzec.is_file():
        print(f"pominięto {plik.name} (brak wzorca w {W.name})")
        continue
    if wczytaj_json(plik) != wczytaj_json(wzorzec):
        (blad if nazwa == "rozklad" else platforma.append)(f"{plik.name} różni się od wzorca")

# Pomiary z 15.10.2026 (ujęcia 17, 32a, 47b), jeśli są we wzorcach i u Ciebie
if (W / "parametry.json").is_file() and (KATALOG / "parametry.json").is_file():
    a, b = wczytaj_json("parametry.json"), wczytaj_json(W / "parametry.json")
    for k in ("parametry_razem", "tabela_slownika", "len_tokenizer", "pozycje_ponad_tokenizer", "config"):
        rowne(a[k], b[k], f"parametry.json {k}")
if (W / "koniec.json").is_file() and (KATALOG / "koniec.json").is_file():
    a, b = wczytaj_json("koniec.json"), wczytaj_json(W / "koniec.json")
    for oa, ob in zip(a["odpowiedzi"], b["odpowiedzi"]):
        if [k["id"] for k in oa["kroki"]] != [k["id"] for k in ob["kroki"]]:
            platforma.append(f"koniec.json: inna odpowiedź na {ob['pytanie']!r}")
            continue
        for ka, kb in zip(oa["kroki"], ob["kroki"]):
            blisko(ka["p_koniec_%"], kb["p_koniec_%"], 0.01, f"koniec.json {ka['kartka']!r} p_koniec")
if (W / "claude_tokeny.json").is_file() and (KATALOG / "claude_tokeny.json").is_file():
    a, b = wczytaj_json("claude_tokeny.json"), wczytaj_json(W / "claude_tokeny.json")
    rowne([(p["pl"]["n"], p["en"]["n"]) for p in a["pary"]], [(p["pl"]["n"], p["en"]["n"]) for p in b["pary"]], "claude_tokeny.json")

for p in platforma:
    print("ZALEŻNE OD PLATFORMY:", p)
if args.scisle:
    bledy += platforma
print("ZGODNE" if not bledy else f"NIEZGODNE: {len(bledy)} różnic")
raise SystemExit(1 if bledy else 0)
Wynik u mnie, po świeżym przebiegu wszystkich skryptów z czystego katalogu: ZGODNE (także z opcją --scisle, która traktuje różne teksty losowań jako błąd).
- Numery i liczby tokenów (tiktoken, tokenizer Qwen3, licznik Claude) są identyczne na każdym komputerze.
- Procenty w rozkładach zgadzają się do 2 miejsc po przecinku. Skrypt dopuszcza różnicę 0,01 i ±1 w liczbie kandydatów z szansą powyżej jednej milionowej.
- Teksty losowań (wzorce w paczce to skróty SHA-256 tekstów, a porównanie działa tak samo) i odpowiedź z eksperymentu o kartce końca: u mnie kolejne przebiegi na Apple M2 (CPU,
float32, te same wersje bibliotek) dały identyczne teksty. Na innym procesorze albo systemie ostatnie cyfry obliczeń mogą się różnić i losowanie potrafi pójść inną drogą. Skrypt pokazuje takie różnice jako „ZALEŻNE OD PLATFORMY”, a błędem są dopiero z opcją--scisle. Na innym systemie tego nie testowałem.
Skąd dane do testu na żywo
Test na żywo wyżej korzysta z próbek wygenerowanych tym samym modelem. Skrypt probki_lab.py losuje po 300 niezależnych próbek dla każdego z sześciu ustawień (dwa zdania, trzy temperatury) i sprawdza, czy częstość lidera zgadza się z pomiarem z eksperymentu 7. Potem filtruj_probki.py odrzuca próbki z adresami internetowymi, urwanymi znakami i słowami wymagającymi ostrożności (u mnie 23 z 1800, czyli 1,3%, a filtr jest celowo ostrożny, więc odrzuca też kilka niewinnych), a rozklad.py zapisuje dane słupków.
python probki_lab.py
python filtruj_probki.py --wyjscie probki.json
python rozklad.py --wyjscie rozklad.json
Pokaż kod: probki_lab.py
"""Prawdziwe próbki do laboratorium na stronie WWW (strona/src/data/probki.json).

Dla każdego zdania (PL "Niebo jest", EN "The sky is") i każdej z trzech temperatur (0,2 / 1,0 / 1,5)
generujemy N niezależnych próbek z Qwen3-0.6B-Base: pierwszy kawałek (token) i dalszy ciąg do 12 tokenów.
Czyste próbkowanie z softmax(z / T): bez Top-K i bez Top-P (wyłączone jawnie).

Ponieważ próbki są niezależne, pierwsze tokeny mają dokładnie ten rozkład, który pokazują słupki (dist2.json),
z szumem losowym rzędu 1/sqrt(N). Skrypt sam to sprawdza i zapisuje w polu "check".

Uruchomienie: python probki_lab.py   (torch 2.14.1, transformers 5.19.0, CPU, float32), wynik: probki-lab.json
"""
import time, warnings
import torch
warnings.filterwarnings("ignore")
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
from _wspolne import MODEL_BAZOWY, REWIZJA_BAZOWY, meta, wczytaj_json, zapisz_json

NAME = MODEL_BAZOWY
PROMPTS = {"pl": "Niebo jest", "en": "The sky is"}
TEMPS = [0.2, 1.0, 1.5]
N = 300
NEW = 12
SEED = 2026

tok = AutoTokenizer.from_pretrained(NAME, revision=REWIZJA_BAZOWY)
model = AutoModelForCausalLM.from_pretrained(NAME, revision=REWIZJA_BAZOWY, dtype=torch.float32).eval()
dist = wczytaj_json("dist2.json")["pairs"][0]  # najpierw pairs.py
res = {"meta": meta(model=NAME, rewizja=REWIZJA_BAZOWY), "model": NAME, "torch": torch.__version__, "n_per_state": N,
       "new_tokens": NEW, "seed": SEED, "sampling": "temperature only, top_k=0, top_p=1.0", "samples": {}, "check": {}}

for lang, prompt in PROMPTS.items():
    ids = tok(prompt, return_tensors="pt")
    plen = ids["input_ids"].shape[1]
    for T in TEMPS:
        set_seed(SEED)
        t0 = time.time()
        with torch.no_grad():
            out = model.generate(**ids, do_sample=True, temperature=T, top_k=0, top_p=1.0, max_new_tokens=NEW,
                                 num_return_sequences=N, pad_token_id=tok.eos_token_id)
        items = []
        for row in out:
            gen = row[plen:].tolist()
            if tok.eos_token_id in gen:
                gen = gen[:gen.index(tok.eos_token_id)]
            if not gen:
                continue
            first = tok.decode(gen[:1])
            # kawałek do wyświetlenia: pierwszy token, a gdy to sama spacja albo urwany znak, razem z kolejnymi
            k, piece = 1, first
            while ("�" in piece or not piece.strip()) and k < min(4, len(gen)):
                k += 1
                piece = tok.decode(gen[:k])
            whole = tok.decode(gen)
            rest = whole[len(piece):] if whole.startswith(piece) else ""
            items.append({"t": first, "p": piece, "r": rest})
        key = f"{lang}|{T}"
        res["samples"][key] = items
        # kontrola: odsetek próbek, których pierwszy token to lider z pomiaru, kontra zmierzone prawdopodobieństwo
        top = dist[lang]["T"][str(T)]["top"]
        lead_tok, lead_p = top[0]
        frac = sum(1 for x in items if x["t"] == lead_tok) / len(items)
        res["check"][key] = {"n": len(items), "lider": lead_tok, "zmierzone_%": lead_p, "w_probkach_%": round(frac * 100, 2),
                             "szum_1sigma_%": round(100 * (lead_p / 100 * (1 - lead_p / 100) / len(items)) ** 0.5, 2)}
        print(f"[{key}] {len(items)} próbek, {time.time() - t0:.0f} s, lider {lead_tok!r}: zmierzone {lead_p}%, w próbkach {frac * 100:.1f}%", flush=True)
        for x in items[:3]:
            print("    ", repr(prompt + x["p"] + x["r"]), flush=True)

zapisz_json("probki-lab.json", res)
Pokaż kod: filtruj_probki.py
"""Filtr próbek do publikacji na stronie: probki-lab.json -> ../../strona/src/data/probki.json.

Model bazowy w "ogonie" rozkładu potrafi wyprodukować adresy internetowe, urwane znaki i słowa wymagające ostrożności.
Takich próbek nie publikujemy. Filtr jest celowo ostrożny, więc odrzuca też kilka niewinnych (np. "killoan").
Liczba odrzuconych jest zapisana w pliku i podana na stronie, bo filtr minimalnie zmienia częstości.
Odrzucamy próbkę, gdy zawiera: znak zastępczy (urwany bajt), @, http, www., .com, .pl albo słowo z listy poniżej.
Uruchomienie: python filtruj_probki.py [--wyjscie ŚCIEŻKA]
Domyślnie: strona/src/data/probki.json, a gdy nie ma takiego katalogu (np. po pobraniu samych skryptów), probki.json obok skryptu.
"""
import argparse, re, collections
from pathlib import Path
from _wspolne import KATALOG, wczytaj_json, zapisz_json

ap = argparse.ArgumentParser()
ap.add_argument("--wyjscie")
args = ap.parse_args()
STRONA = (KATALOG / "../../strona/src/data").resolve()
WYJSCIE = Path(args.wyjscie) if args.wyjscie else (STRONA if STRONA.is_dir() else KATALOG) / "probki.json"

BAD = re.compile(r"kurw|chuj|huj|pierdol|jeb[aeiouy]|pizd|szmat|dziwk|skurw|sex|porn|fuck|shit|bitch|cunt|dick|pussy|nigg|fag|rape|nazi|hitler|suicid|whore|cock|slut|kill|murder|terror|bomb|isis|jihad|xxx|nude|naked|escort", re.I)
NET = re.compile(r"https?://|www\.|@|\.com|\.pl\b")

src = wczytaj_json("probki-lab.json")
dist = wczytaj_json("dist2.json")["pairs"][0]
out = {"model": src["model"], "new_tokens": src["new_tokens"], "sampling": src["sampling"], "seed": src["seed"], "samples": {}, "odrzucone": {}, "check": {}}
removed = collections.Counter()
for key, items in src["samples"].items():
    kept = []
    for s in items:
        txt = s["p"] + s["r"]
        if "�" in txt or NET.search(txt) or BAD.search(txt):
            removed[key] += 1
        else:
            kept.append(s)
    out["samples"][key] = kept
    lang, T = key.split("|")
    lead_tok, lead_p = dist[lang]["T"][str(float(T))]["top"][0]
    frac = 100 * sum(1 for s in kept if s["t"] == lead_tok) / len(kept)
    out["odrzucone"][key] = removed[key]
    out["check"][key] = {"n": len(kept), "lider": lead_tok, "zmierzone_%": lead_p, "w_probkach_%": round(frac, 2)}
    print(f"{key}: zostało {len(kept)}, odrzucono {removed[key]}, lider {lead_tok!r}: zmierzone {lead_p}% vs w próbkach {frac:.1f}%")
total_removed = sum(removed.values()); total = sum(len(v) for v in src["samples"].values())
out["n_per_state"] = min(len(v) for v in out["samples"].values())
print(f"razem odrzucono {total_removed} z {total} ({100 * total_removed / total:.1f}%)")
zapisz_json(WYJSCIE.resolve(), out, indent=None, separators=(",", ":"))
Pokaż kod: rozklad.py
"""Dane słupków na stronę WWW: dist2.json -> strona/src/data/rozklad.json.

Bierze pierwszą parę z dist2.json ("Niebo jest" / "The sky is"), temperatury w kolejności 0,2 / 1,0 / 1,5,
osiem pierwszych kandydatów i liczbę kandydatów z szansą > 1e-6 (pole "n").
Uruchomienie: python rozklad.py [--wyjscie ŚCIEŻKA] [--data RRRR-MM-DD]   (najpierw pairs.py)
Domyślnie: strona/src/data/rozklad.json, a gdy nie ma takiego katalogu (np. po pobraniu samych skryptów), rozklad.json obok skryptu.
"""
import argparse
from pathlib import Path
from _wspolne import KATALOG, wczytaj_json, zapisz_json

ap = argparse.ArgumentParser()
ap.add_argument("--wyjscie")
ap.add_argument("--data", default="2026-10-09", help="data pomiaru pokazywana na stronie")
args = ap.parse_args()

dist = wczytaj_json("dist2.json")
para = dist["pairs"][0]
out = {"model": dist["model"], "vocab": dist["logits_dim"], "date": args.data, "prompts": {}}
for lang in ("pl", "en"):
    r = para[lang]
    out["prompts"][lang] = {
        "prompt": r["prompt"], "tokens": r["tokens"],
        "T": {T: {"top": r["T"][T]["top"], "top8_sum": r["T"][T]["top8_sum"], "n": r["T"][T]["n_over_1e-6"]}
              for T in sorted(r["T"], key=float)},
    }
STRONA = (KATALOG / "../../strona/src/data").resolve()
WYJSCIE = Path(args.wyjscie) if args.wyjscie else (STRONA if STRONA.is_dir() else KATALOG) / "rozklad.json"
zapisz_json(WYJSCIE.resolve(), out)Cały wynik jako tekst (do skopiowania)
$ python probki_lab.py
Loading weights: 100%|██████████████████████████████████████████| 310/310 [00:01<00:00, 181.20it/s]
[pl|0.2] 300 próbek, 21 s, lider ' ': zmierzone 73.96%, w próbkach 76.3%
'Niebo jest 1000 km od Gliwice.'
'Niebo jest 100 km od domu. Jeden z'
'Niebo jest 150 km od Gliwice. G'
[pl|1.0] 300 próbek, 15 s, lider ' ': zmierzone 9.0%, w próbkach 10.0%
'Niebo jest już w Starych staniekach. Teraz'
'Niebo jest robotą jednostka programu Microsoft Police eMail Ma'
     'Niebo jest pijarskim często w plecach, a tronz'
[pl|1.5] 300 próbek, 15 s, lider ' ': zmierzone 1.99%, w próbkach 3.7%
     'Niebo jest już Hell. Der lavender Harvest Ground work covered in camping areas'
     'Niebo jest robot któregoinarció_NojoInfo\n\nPro lamp of ky'
     'Niebo jest pijarskim częstoleta plenego cybersecurityjob datab컵 mão'
[en|0.2] 300 próbek, 15 s, lider ' blue': zmierzone 96.47%, w próbkach 96.3%
     'The sky is blue because the molecules in the air are _________. \n\n'
     'The sky is blue because the air is thin.  The air is thin'
     'The sky is blue because the molecules in the air are ________.\nAnswer'
[en|1.0] 300 próbek, 17 s, lider ' blue': zmierzone 20.96%, w próbkach 20.0%
     'The sky is turning to cold starts lavender petals endangered work covered in imperfections'
     'The sky is getting dark... Can you imagine the dark in summer of this'
     'The sky is raining. The river is running. The forest is silent and'
[en|1.5] 300 próbek, 17 s, lider ' blue': zmierzone 4.8%, w próbkach 4.0%
     'The sky is turning Hell. New lavender Harvest Ground work covered in camping areas'
     'The sky is getting broke... Can_No-how somewhat hast in saying of this'
     'The sky is raining. Everyone wears arm air birthday presents (tip컵 mão'
zapisano probki-lab.json
$ python filtruj_probki.py --wyjscie probki.json
pl|0.2: zostało 300, odrzucono 0, lider ' ': zmierzone 73.96% vs w próbkach 76.3%
pl|1.0: zostało 298, odrzucono 2, lider ' ': zmierzone 9.0% vs w próbkach 10.1%
pl|1.5: zostało 288, odrzucono 12, lider ' ': zmierzone 1.99% vs w próbkach 3.8%
en|0.2: zostało 299, odrzucono 1, lider ' blue': zmierzone 96.47% vs w próbkach 96.3%
en|1.0: zostało 300, odrzucono 0, lider ' blue': zmierzone 20.96% vs w próbkach 20.0%
en|1.5: zostało 292, odrzucono 8, lider ' blue': zmierzone 4.8% vs w próbkach 3.8%
razem odrzucono 23 z 1800 (1.3%)
zapisano probki.json
$ python rozklad.py --wyjscie rozklad.json
zapisano rozklad.jsonW paczce nie ma surowych losowań: wzorce losowanie.json i probki-lab.json mają zamiast tekstów ich skróty SHA-256, a sprawdz.py porównuje je z Twoimi tekstami. Twoje własne pliki losowanie.json i probki-lab.json będą za to zawierać surowe wyniki małego modelu bez filtra, czyli czasem przypadkowe adresy, przekleństwa i treści brutalne, więc przejrzyj je, zanim gdzieś wkleisz.
Środowisko i wersje
Python 3.11, tiktoken 0.14.0, transformers 5.19.0, torch 2.14.1, procesor Apple M2, float32. Pomiary z filmu pochodzą z 9–15 października 2026, a 15 i 16 października powtórzyłem je wszystkie od zera, z przypiętymi wersjami: wyniki były identyczne. Modele: Qwen/Qwen3-0.6B-Base (rewizja da87bfb) do wszystkich eksperymentów poza kartką końca oraz Qwen/Qwen3-0.6B (wersja czatowa, rewizja c1899de) tylko do eksperymentu 9. Czasy z nagrań dotyczą uruchomień z modelem już pobranym do pamięci podręcznej.
Źródła
Przystanek 1, cięcie na tokeny
- Sennrich, Haddow, Birch (2016), Neural Machine Translation of Rare Words with Subword Units
- Petrov, La Malfa, Torr, Bibi (2023), Language Model Tokenizers Introduce Unfairness Between Languages
- Ahia i in. (2023), Do All Languages Cost the Same? Tokenization in the Era of Commercial Language Models
- Brown i in. (2020), Language Models are Few-Shot Learners (dane treningowe GPT-3: głównie angielski, 93% słów)
- OpenAI, repozytorium openai/gpt-3, plik dataset_statistics/languages_by_word_count.csv (w danych GPT-3 angielski to 92,6% słów, polski 0,16%; sprawdzone 15 października 2026)
- Wan, Klyman, Kapoor i in. (2025), The 2025 Foundation Model Transparency Index, wskaźnik 17 „Data language composition” (OpenAI, Anthropic i Google nie ujawniają składu językowego danych)
- Dokumentacja Anthropic, Token counting (modele od Claude 4.7 mają nowszy tokenizer, który na tym samym tekście daje ok. 30% więcej tokenów)
- Dokumentacja OpenRouter, API reference (liczba tokenów w odpowiedzi jest liczona natywnym tokenizerem modelu)
Przystanek 2, liczby i mapa znaczeń
- Mikolov, Chen, Corrado, Dean (2013), Efficient Estimation of Word Representations in Vector Space
- Vaswani i in. (2017), Attention Is All You Need (informacja o pozycji tokenu, warstwy z attention, generowanie token po tokenie, wspólna macierz wag wejścia i wyjścia: sekcja 3.4)
Przystanek 3, maszyna
- Karta modelu Qwen3-0.6B-Base (28 warstw, 0,6 mld parametrów, w tym 0,44 mld bez embeddingów, licencja Apache 2.0)
- Plik config.json modelu Qwen3-0.6B-Base (28 warstw, wektor 1024 liczb, 151 936 pozycji tabeli, wspólna tabela wejścia i wyjścia: tie_word_embeddings)
- Qwen Team (2025), Qwen3 Technical Report (obsługiwane języki, w tym polski; tokenizer BBPE ze słownikiem 151 669 pozycji)
Przystanek 4, losowanie i temperatura
- Hinton, Vinyals, Dean (2015), Distilling the Knowledge in a Neural Network (softmax z temperaturą, równanie 1)
- Dokumentacja Hugging Face Transformers, GenerationConfig v5.19.0 (temperature, do_sample, top_k, top_p)
- Dokumentacja Hugging Face Transformers v5.19.0, GenerationConfig (kartka końca to zwykły token,
eos_token_id; drugi hamulec to limit długości,max_new_tokens) - Plik generation_config.json czatowego modelu Qwen3-0.6B (kartki końca
<|im_end|>151645 i<|endoftext|>151643) - Holtzman, Buys, Du, Forbes, Choi (2020), The Curious Case of Neural Text Degeneration
Co uprościłem
- Dokumentacja Hugging Face, Chat templates
- Ouyang i in. (2022), Training language models to follow instructions with human feedback
Odcinek powstał we współpracy z AI: autor kanału wybrał temat, sprawdził scenariusz i zweryfikował źródła; scenariusz, pomiary i animacje przygotowało AI. Narracja jest syntetyczna (głos ElevenLabs). Animacje: HTML i SVG, wyrenderowane lokalnie.